La verità sintetica sta divorando indagini e processo penale
La verità sintetica sta divorando indagini e processo penale

Una volta si discuteva del rapporto epistemologico tra verità e verità processuale. Di questa se ne accettavano i limiti perché destinata a regolare funzionalmente i rapporti tra consociati nel bilanciamento tra certezza e ordine. La verità prodotta dall’intelligenza artificiale è costante falsificazione creativa e percettiva, che modifica anche la memoria autobiografica delle persone e la materialità dell’ ”oggettivo” e altera la valutazione della prova, rendendo ormai la categoria della verità processuale non più parte della realtà, della verità e della sua conoscibilità. Il leviatano è divenuto demiurgo. Proprio nel momento in cui la prova digitale diventa il baricentro, diretto o indiretto, di ogni indagine penale (perché l’uomo è parte di un tessuto digitale dalle maglie sempre più strette), i crimini legati all’AI generativa condizionano e subornano anche la prova analogica. Quello a cui assistiamo (per lo più inconsapevolmente) con i crimini legati alla AI e, in particolare deepfake, phishing, sextortion è solo sineddoche della crisi della prova nell’era dei contenuti sintetici.

L’intelligenza artificiale generativa non ha soltanto ampliato la capacità di produrre contenuti, ma ha incrinato – forse definitivamente – uno dei presupposti più fragili della convivenza digitale: la fiducia nell’autenticità di ciò che vediamo, ascoltiamo e leggiamo. Deepfake, phishing evoluto, sextortion e pornografia artificiale mostrano come l’inganno non dipenda più soltanto dalla falsità del contenuto, ma dalla sua plausibilità, dalla sua rapidissima diffusione e dalla capacità di colpire emozioni, reputazione, patrimonio e autodeterminazione. In questo scenario, la minaccia non riguarda solo la commissione di nuovi reati o il potenziamento di quelli tradizionali, ma investe anche direttamente la tenuta della prova audiovisiva, la credibilità delle relazioni digitali, la tenuta del sistema processuale e l’effettività delle risposte sanzionatorie. L’AI generativa, infatti, non ha soltanto moltiplicato la capacità di produrre contenuti, ma li ha resi altamente credibili, difficilmente verificabili, praticamente gratuiti ed alla portata di tutti. Il punto non è più stabilire se l’intelligenza artificiale possa essere usata per commettere reati, ma comprendere come stia trasformando le modalità per commetterli.

La statistica dei crimini legati specificamente all’AI generativa è ancora incompleta, perché le principali banche dati classificano i fatti per tipologia – truffe, estorsioni, sfruttamento sessuale, manipolazioni informative – e non ancora per tecnologia impiegata. Eppure, i dati disponibili sono ormai troppo convergenti per essere liquidati come passeggeri segnali di cambiamento. Europol, nel SOCTA 2025, descrive l’AI come fattore di trasformazione della criminalità organizzata, un moltiplicatore strutturale capace di accrescerne efficienza, ordine di grandezza e adattabilità[1]. Nel rapporto Threat Landscape 2025, ENISA rileva che i cybercriminali sfruttano sempre più l’intelligenza artificiale per aumentare produttività e capacità operative, e conferma che il phishing resta il mezzo di compromissione più diffuso, rappresentando circa il 60% dei casi osservati[2]. Nel 2024 Internet Crime Report, l’FBI ha registrato 859.532 denunce e 16,6 miliardi di dollari di perdite; il solo phishing tramite “spoofing”[3] (attacco informatico con uso di false identità) conta 193.407 segnalazioni, mentre il “Business Email Compromise” genera perdite per oltre 2,77 miliardi di dollari[4].

Il quadro si fa ancora più allarmante rispetto ai reati che colpiscono i minori. Il National Center for Missing & Exploited Children (NCMEC) segnala che nel 2024 la CyberTipline[5] ha ricevuto 20,5 milioni di report, corrispondenti a 29,2 milioni di incidenti distinti; le segnalazioni di “online enticement” (adescamento online), categoria che include la sextortion, superano le 546.000, con un incremento del 192% rispetto al 2023[6]. Nello stesso anno, le segnalazioni che coinvolgono l’uso di Generative AI sono cresciute del 1.325%, passando da 4.700 a 67.000[7]. Nel 2024, infine, l’Internet Watch Foundation ha individuato 245 report contenenti immagini di abuso sessuale su minori generate dall’AI, in aumento del 380% rispetto all’anno precedente[8].

1. La Gen AI: un’overview

L’intelligenza artificiale generativa (o generative AI) è una branca dell’AI che consente ai sistemi informatici di creare nuovi contenuti originali, come testi, immagini, musica, video o codice, partendo da dati di addestramento esistenti. A differenza dei modelli tradizionali di AI, progettati per classificare o riconoscere dati, i sistemi generativi sono in grado di produrre contenuti nuovi, che spesso risultano indistinguibili da quelli creati da esseri umani.

Il funzionamento dell’AI generativa si basa su reti neurali profonde (deep neural networks), in particolare su un’architettura chiamata trasformatore (transformer), introdotta nel 2017 da un gruppo di ricercatori di Google[9]. Questa architettura è alla base di molti modelli di linguaggio avanzati come GPT (Generative Pre-trained Transformer) di OpenAI, PaLM di Google, Claude di Anthropic o LLaMA di Meta.

I modelli generativi sono solitamente pre-addestrati su enormi quantità di dati, spesso prelevati dal web, e successivamente ottimizzati per svolgere compiti specifici (ad esempio la scrittura automatica, la generazione di immagini o la creazione di codice). Durante l’addestramento, il modello apprende le strutture statistiche e semantiche del linguaggio o dei dati visivi, in modo da poterli riprodurre in maniera credibile.

Un esempio molto noto di AI generativa è ChatGPT, sviluppato da OpenAI, che può sostenere conversazioni complesse, scrivere saggi, rispondere a domande tecniche e persino imitare stili letterari. Altri strumenti come DALL-E o Midjourney generano immagini realistiche partendo da una semplice descrizione testuale (prompt), mentre altri, come Synthesia, permettono la creazione di video a partire da input linguistici.

Dal punto di vista tecnico, il cuore della generazione consiste nell’autocompletamento predittivo: il modello calcola la probabilità che una parola (o un pixel, o una nota musicale) segua un’altra, e genera sequenze coerenti sulla base di questo calcolo. Per i modelli linguistici, ad esempio, ciò avviene parola per parola o token per token, scegliendo quelli statisticamente più plausibili in relazione al contesto fornito dall’utente.

Per quanto riguarda i deepfake, questa tecnologia implica spesso l’uso di una “rete neurale” per l’apprendimento automatico[10]. La rete neurale inizia come una sorta di tabula rasa, caratterizzata da una rete nodale controllata da un insieme di parametri numerici impostati casualmente[11]. Proprio come l’esperienza affina i nodi neurali del cervello, gli esempi addestrano il sistema della rete neurale[12]. Se la rete elabora un’ampia gamma di esempi di addestramento, è poi in grado di creare modelli sempre più accurati[13]. È attraverso questo processo che le reti neurali classificano audio, video o immagini e generano imitazioni o alterazioni realistiche.

Di per sé, l’emergere dell’apprendimento automatico tramite metodi basati su reti neurali preannuncia un aumento significativo della capacità di creare immagini, video e audio falsi. Ma la storia non finisce qui. Entrano in scena le “reti generative avversarie”, GAN (Generative Adversarial Networks)[14]. Queste ultime, inventate dal ricercatore di Google Ian Goodfellow, utilizzano simultaneamente due reti neurali: una, detta generatore, attinge da un insieme di dati per produrre un campione che imiti tali dati; l’altra, il discriminatore, valuta quanto il generatore abbia avuto successo. In modo iterativo, le valutazioni del discriminatore perfezionano il lavoro del generatore. Il risultato supera di gran lunga la velocità, la portata e la finezza che potrebbero ottenere i revisori umani, di talché la crescente sofisticazione dell’approccio GAN porterà inevitabilmente alla produzione di deepfake sempre più convincenti[15].

2. Dalla generazione del contenuto alla generazione dell’inganno

La GenAI è spesso descritta come una tecnologia “creativa”. Sul piano giuridico, però, la sua qualità più rilevante è un’altra: la capacità di produrre output plausibili, adattabili al contesto e difficili da distinguere da quelli umani. I modelli generativi contemporanei discendono dall’evoluzione delle architetture di apprendimento profondo, in particolare dai transformer, introdotti nel 2017, che hanno reso possibile trattare enormi sequenze di dati testuali, visivi e audiovisivi in modo molto più efficiente dei modelli precedenti[16]. L’OCSE ha osservato che la GenAI impone ai governi una sfida nuova: governare una tecnologia capace di trasformare informazione, mercato e relazioni sociali senza sacrificare diritti fondamentali, affidabilità e fiducia pubblica[17].

Se in passato la manipolazione sofisticata di immagini, audio e video restava in gran parte confinata a soggetti altamente specializzati, oggi strumenti commerciali, spesso intuitivi e relativamente economici, consentono a una platea molto più ampia di produrre contenuti sintetici più o meno pericolosi. È qui che la questione smette di essere esclusivamente tecnologica ed entra nella vita reale generando non solo fattispecie di reato del tutto nuove, ma anche facendo acquisire una potenza offensive diversa a reati già noti quali frode, estorsione, diffamazione, sostituzione di persona e manipolazione probatoria, alterando i presupposti di credibilità dell’inganno[18].

Un esempio divenuto ormai paradigmatico è l’esperimento dell’Università di Washington sul volto di Barack Obama. Alcuni ricercatori, utilizzando uno strumento basato su rete neurale da loro creato, hanno mostrato come, disponendo di materiale audiovisivo sufficiente, fosse possibile produrre un video in cui l’ex presidente pronunciava frasi mai dette[19]. Quel caso aveva una funzione dimostrativa. Oggi, però, il problema non è più stabilire se ciò sia possibile, ma riconoscere che la medesima logica è ormai spendibile in frodi affettive, falsi comunicati, video-ricatti, vocal clone o pseudo-prove. In altre parole, la GenAI non genera soltanto contenuti: crea situazioni verosimili e credibili[20].

3. La criminalità persuasiva: phishing, voice cloning e frodi deepfake

It can happen on an international and serious organised crime scale, and it can happen in someone’s bedroom … You can think of any crime type and put it through an AI lens and say: “What is the opportunity here?” (Alex Murray, UK National Crime Agency)[21]

Il primo terreno sul quale la GenAI ha mostrato in modo plastico la propria capacità criminogena è quello della frode persuasiva. Il phishing è una forma di ingegneria sociale in cui l’autore del reato si finge un contatto affidabile e induce la vittima a condividere informazioni sensibili, come password o dati bancari[22]. Il phishing tradizionale era spesso riconoscibile per errori grammaticali, formule standardizzate, registri maldestri. La GenAI riduce proprio questi segnali: produce testi corretti, imita stili comunicativi, costruisce identità digitali verosimili, personalizza messaggi su destinatari specifici e imita stili di scrittura aggirando i controlli, sfruttando le vulnerabilità dei filtri e-mail e delle abitudini degli utenti. L’effetto non è solo quantitativo, ma qualitativo: il falso appare più credibile perché somiglia sempre di più alla comunicazione ordinaria[23].

L’Anti-Phishing Working Group (APWG) ha osservato 1.130.393 attacchi nel secondo trimestre del 2025, il valore trimestrale più alto dalla metà del 2023[24]; nel quarto trimestre, inoltre, i bersagli principali sono risultati i servizi di social media e SaaS/Webmail, ciascuno pari al 20,3% degli attacchi osservati, mentre lo smishing (phishing via SMS) ha continuato a crescere del 30-40% trimestralmente[25]. Inoltre, ENISA rileva che all’inizio del 2025 le campagne di phishing supportate dall’AI rappresentavano già oltre l’80% dell’attività di social engineering osservata[26]. Microsoft aggiunge che le e-mail di phishing automatizzate con AI raggiungono tassi di click del 54%, contro il 12% dei tentativi standard[27]. Nella stessa direzione va l’FBI, secondo cui nei primi sette mesi del 2025 l’AI compare in oltre 9.000 segnalazioni, distribuite tra diverse forme di frode online[28].

L’FBI ha avvertito che i criminali usano la GenAI per facilitare frodi finanziarie su scala più ampia, sfruttando immagini artificiali, testi convincenti, audio clonati e video sintetici per rendere l’inganno più plausibile[29]. La FTC, dal canto suo, ha segnalato il rischio crescente dei sistemi di voice cloning, capaci di riprodurre la voce di un familiare o di un superiore gerarchico e di attivare una risposta emotiva immediata nella vittima[30]. L’elemento interessante, dal punto di vista giuridico, è che l’AI non interviene soltanto nell’atto finale della frode, ma già nella costruzione del contesto fiduciario: crea la relazione apparente che induce la vittima a credere, reagire d’impulso e abbassare le proprie difese.

Non sorprende, allora, che gli esempi più recenti siano sempre meno “artigianali” e sempre più organizzati. Nel febbraio 2025 la Hong Kong Police ha annunciato di avere smantellato due organizzazioni criminali che impiegavano deepfake e identità sintetiche per frodi online, con 58 arresti e perdite complessive stimate in circa 400 milioni di dollari di Hong Kong[31]. Non esistono però solo frodi economiche in senso classico. L’FBI ha diffuso nel 2025 un’allerta sulle forme di c.d. “virtual kidnapping” (rapimento virtuale) in cui i criminali usano immagini o video alterati come falsa “proof of life” per rendere più credibili richieste estorsive per rapimenti inesistenti[32]. Il salto qui è evidente: la GenAI rende più facile simulare non solo un messaggio, ma un’intera scena emotiva[33].

In questo senso, il phishing generativo rappresenta qualcosa di più di un semplice aggiornamento tecnologico dell’ingegneria sociale. È l’emersione di una criminalità persuasiva, nella quale il contenuto falso vale non tanto per ciò che dice, quanto per la sua capacità di inserirsi in una relazione già plausibile. È precisamente questo elemento che spiega perché la risposta del diritto non possa esaurirsi nella sola repressione del fatto consumato: quando l’inganno è automatizzato, personalizzato e scalabile, la prevenzione e la trasparenza diventano parte della risposta giuridica tanto quanto la sanzione[34].

4. Sextortion, pornografia sintetica e sessualità artificiale non consensuale

Se la frode mostra il lato economicamente più visibile della GenAI, il suo impatto più disturbante emerge nei reati che colpiscono la sessualità e la vulnerabilità delle persone. La sextortion, già nota prima dell’esplosione dell’AI generativa, cambia natura quando l’autore non si limita a minacciare la diffusione di materiale reale, ma può creare o alterare contenuti sessualmente espliciti a partire da fotografie innocue, immagini reperite online o semplici dati identificativi. In questo caso, la minaccia non riguarda più soltanto ciò che esiste, ma ciò che può essere reso credibile in pochi minuti[35].

Questa trasformazione non si esaurisce, tuttavia, nella singola condotta estorsiva o nella manipolazione di un contenuto. Come ha osservato recentemente Internazionale[36], riprendendo un’analisi di The Economist, l’intelligenza artificiale sta rimodellando l’intera economia della pornografia digitale: dai generatori di immagini esplicite alle app di nudify, fino alle piattaforme che devono decidere se ammettere, monetizzare o almeno etichettare contenuti sintetici apparentemente autentici.

In questo contesto, sextortion, deepfake pornografici e sfruttamento dell’immagine altrui non appaiono più come deviazioni episodiche, ma come lo scenario pervasivo ed in crescita esponenziale che sta rimodellando i confini stessi della pornografia, della sua fruizione e dell’immaginario ad essa collegati, con inquietanti e potenziali normalizzazioni delle devianze illecite nella vita reale, soprattutto per quanto riguarda i minori.

I dati inglesi del NCMEC, ad esempio, confermano la portata del fenomeno. Nel 2024 i report di “online enticement” (adescamento online) superano le 546.000 unità, con una crescita del 192% rispetto all’anno precedente; la stessa organizzazione riferisce di ricevere quasi 100 segnalazioni al giorno di “financial sextortion” (ovvero quelle condotte estorsive, perpetrate attraverso la rete, caratterizzate dalla minaccia di diffondere immagini o video sessualmente espliciti che ritraggono la vittima, al fine di ottenere qualcosa da quest’ultima), e di essere a conoscenza, dal 2021, di almeno 36 adolescenti che si sono tolti la vita dopo essere stati vittime di sextortion[37].

Il 2024, inoltre, si è concluso con alcuni eclatanti casi giudiziari in materia di intelligenza artificiale. In particolare, un ventisettenne di Bolton (UK), Hugh Nelson, è stato condannato a 18 anni di reclusione per aver creato con l’intelligenza artificiale immagini di abusi su bambini, utilizzando come base delle foto di minori realmente esistenti[38]. Si è trattato del primo processo di questo genere in Inghilterra.

Nelson aveva utilizzato Daz 3D, un programma per computer con una funzione di intelligenza artificiale, per trasformare le immagini “normali” in immagini di abusi. In alcuni casi, i pedofili avevano commissionato le immagini, fornendo direttamente fotografie di minori con cui avevano avuto contatti nella vita reale.

Dalla vendita delle immagini su diverse chat online ha guadagnato circa cinquemila sterline durante un periodo di 18 mesi.

Sebbene ci siano state precedenti condanne per deepfake (nei quali spesso si sovrappone un volto alle azioni commesse da un altro corpo) la novità di questo caso è rappresentata proprio dalla creazione integrale di personaggi 3D da fotografie innocue[39].

In questa direzione l’Internet Watch Foundation, nel 2024 ha segnalato un aumento del 380% dei report relativi a immagini di abuso sessuale su minori generate dall’AI[40].

Il danno non consiste soltanto nell’eventuale acquisizione abusiva di immagini autentiche, ma nella costruzione artificiale di una sessualità artefatta e non voluta, nella mercificazione del corpo rappresentato, nella minaccia reputazionale e nella capacità del contenuto artificiale di circolare come se fosse vero. È per questo che il dibattito normativo si sta spostando verso categorie più ampie, come quella dei contenuti intimi non consensuali, idonee a ricomprendere anche immagini e video generati o alterati artificialmente[41].

La crescita del ricorso a immagini generate dall’AI per soddisfare il mercato nero degli abusanti porta con sé una sfida alla tenuta delle norme in materia, concepite in tutt’altra epoca. Assumono sempre maggiore rilevanza, dunque, quelle pronunce della Corte di Cassazione italiana che, già da tempo, hanno iniziato a qualificare come materiale pedopornografico fumetti e illustrazioni di racconti erotici raffiguranti minorenni, ritenendo di dover includere in tale nozione tutto ciò che sia idoneo a dare allo spettatore l’idea che oggetto della rappresentazione pornografica sia un minore[42].

5. Le difficoltà del riconoscimento

Le diverse tipologie di deepfake, da quelle più semplici, come il face-swapping, fino al lip-syncing e al puppet-mastery (rispettivamente lo scambio di volti, la sincronizzazione di un video di una persona che parla con un diverso audio, l’animazione di un soggetto inesistente), possono essere tanto complesse da realizzare in maniera realistica quanto poi ostiche da distinguere da immagini reali.

 Sebbene nel tempo, di pari passo con l’evoluzione della tecnologia generativa, siano stati compiuti notevoli progressi nelle prestazioni dei rilevatori di deepfake, esistono tuttora notevoli limiti che impediscono una completa ed efficace individuazione.

In primo luogo, come sempre avviene per le tecnologie AI che necessitano di apprendere per migliorare, l’accessibilità a grandi database di deepfake rappresenta un fattore determinante per lo sviluppo di tecniche di rilevamento efficaci. Tuttavia, analizzando la qualità dei video presenti in questi dataset emergono diverse ambiguità rispetto ai contenuti manipolati realmente presenti su Internet. Le più comuni tipologie in questi database sono lo sfarfallio temporale in alcuni momenti durante il discorso, la sfocatura attorno alle regioni facciali, l’eccessiva levigatezza nella texture del viso o la mancanza di dettagli, l’assenza di movimenti o rotazioni della testa, l’assenza di oggetti che ostruiscono il volto (occhiali, effetti di luce e simili), la sensibilità alle variazioni nella postura o nello sguardo, ad esempio con incoerenze nel colore della pelle. Le ambiguità citate derivano da imperfezioni nei passaggi delle tecniche di manipolazione. Inoltre, contenuti di bassa qualità difficilmente risultano convincenti o in grado di creare una reale impressione. Pertanto, anche se i metodi di rilevamento si dimostrano efficaci su tali video, non è garantito che mantengano le stesse prestazioni in situazioni reali, con foto e video creati con tecniche più avanzate.

Inoltre, i metodi di rilevamento dei deepfake sono formulati come un problema di classificazione binaria, in cui ogni campione è etichettato come vero o falso. Questo tipo di classificazione è più semplice in ambienti controllati, dove si sviluppano e testano le tecniche utilizzando contenuti audio-visivi di cui è nota l’origine – originali o falsificati. Tuttavia, nell’applicazione sul campo, i video possono essere alterati in modi diversi dai deepfake, per cui un contenuto non rilevato come manipolato non è necessariamente autentico (es. Photoshop). Inoltre, un contenuto deepfake può presentare più tipi di alterazione, sia audio che visiva, rendendo poco accurata una singola etichetta. In contenuti con più volti, di solito uno o più di essi vengono manipolati con deepfake solo in alcune sequenze. Pertanto, lo schema di classificazione binaria dovrebbe essere ampliato a classificazioni multicategoria/multi-etichetta e a una classificazione/rilevamento locale a livello di fotogramma, per rendere più efficace l’analisi.

I metodi più elementari di rilevamento dei deepfake, dunque, sono generalmente progettati per analisi in batch su grandi dataset. Tuttavia, quando tali tecniche vengono impiegate da giornalisti o forze dell’ordine, spesso è disponibile solo un numero limitato di video. Inoltre, un punteggio numerico che rappresenta la probabilità che un contenuto sia reale o falso ha scarso valore se non accompagnato da una spiegazione che giustifichi tale punteggio, ma la maggior parte dei metodi di rilevamento, soprattutto quelli basati su tecniche di deep learning, non offre tali spiegazioni a causa della loro natura di “black-box”, cioè di scatola nera di cui – dall’esterno – non si può conoscere il funzionamento[43].

6. Deepfake e giustizia: la crisi della prova audiovisiva

Una riflessione giuridica completa sul tema deve necessariamente confrontarsi con gli impatti dell’AI Generativa sul rapporto tra verità e accertamento processuale: gli effetti dei deepfake, infatti, non sono solo limitati alla diffusione del falso, ma sono tali da minare la fiducia nel vero. La prova audiovisiva ha tradizionalmente beneficiato, in molti contesti, di una sorta di affidamento pratico: un video “mostra”, una fotografia “documenta”, un audio “registra”. I deepfake stravolgono questi assunti e incrinano proprio questa fiducia di base, dando luogo ad una delle più grandi minacce della società contemporanea[44].

La difficoltà, però, non è solo culturale ma anche tecnica. I limiti strutturali dei sistemi di rilevamento sono noti: dataset non pienamente rappresentativi, classificazione binaria troppo rigida, scarsa trasparenza dei modelli, vulnerabilità a bias di razza e genere, difficoltà a trattare contenuti multimodali e alterazioni locali. La valutazione forense dei deepfake, peraltro, si deve oggi confrontare con l’utilizzo di tecniche di anti-forensics[45], utilizzate proprio per rendere difficile la ricostruzione forense e volte a nascondere gli elementi utili all’accertamento dei falsi. Ad esempio, uno strumento di rilevazione di contenuti AI può rivelarsi molto meno affidabile quando gli stessi sono stati caricati, compressi, riconvertiti e diffusi attraverso piattaforme social[46].

Le piattaforme social come Twitter, Facebook o Instagram, che sono i principali canali online utilizzati per diffondere contenuti audiovisivi, per risparmiare banda di rete privano tali contenuti dei metadati, li sottopongono a downsampling (processo di riduzione della definizione) e li comprimono in modo significativo prima del caricamento. Queste manipolazioni, comunemente conosciute come social media laundering, eliminano indizi relativi a eventuali falsificazioni sottostanti e aumentano il tasso di falsi positivi nei rilevamenti. I metodi di rilevamento basati su punti chiave a livello di segnale sono particolarmente vulnerabili a questo tipo di distorsione. Una misura efficace per migliorare l’accuratezza dei rilevatori su contenuti “ripuliti” dai social media è includere tali effetti nei dati di addestramento, ampliando al contempo i database di valutazione con contenuti visivi manipolati tramite social network.

7. L’ingresso dei deepfake nella giustizia

Tra le preoccupazioni per l’utilizzo malevolo dei deepfake spicca il possibile ruolo di questa tecnologia per la manipolazione della formazione della prova nei processi, penali e non solo. Già nel 2021, in uno studio della Commissione europea si osservava come i deepfake sollevassero “serie preoccupazioni riguardo alla fondamentale credibilità e ammissibilità delle registrazioni audiovisive come prove elettroniche nei tribunali”[47].

Ed infatti, la prima conseguenza nell’opinione pubblica del diffuso utilizzo dei deepfake è l’erosione della fiducia nelle istituzioni e nel concetto di verità, con un danno evidente alla credibilità del sistema giudiziario.

Questa tecnologia, infatti, costringe lo spettatore a rivalutare il livello di fiducia riposto nei video e nelle immagini con cui interagisce, in particolare in ambito giudiziario, proprio perché possono apparire estremamente realistici ma essere in realtà del tutto falsi; ed anche quando lo spettatore è consapevole della falsità del contenuto, la percezione può comunque influenzare il subconscio. La loro mera esistenza mina la fiducia “intrinseca” che viene normalmente attribuita a prove video e fotografiche[48].

Nella maggior parte degli ordinamenti, inoltre, il vuoto normativo derivante dalla novità della materia rende difficile scegliere in quale fattispecie penale inquadrare l’uso dei deepfake. All’estero, si è suggerito di ricorrere alle discipline – civili e penali – riguardanti il diritto d’autore[49], che tuttavia è spesso limitante. Sarebbe preferibile, al contrario, l’introduzione diffusa di nuove discipline specifiche, sulla scorta (in UE) della strada già tracciata dall’AI Act, come si vedrà più avanti[50].

L’aspetto più critico, in ogni caso, riguarda il valore che normalmente viene attribuito a prove documentali quali immagini e video[51], spesso ammessi senza alcun genere di accertamento informatico sulla loro genuinità, provenienza e originalità. Talvolta, l’unica garanzia sulla provenienza è la mera integrità della catena di custodia dei file e dei dispositivi in cui sono contenuti, che tuttavia non danno alcuna garanzia sulla genuinità del contenuto ab origine[52]. Questa fiducia “intrinseca” è ulteriormente dimostrata dal fatto che – nella maggior parte degli ordinamenti – questi accertamenti sono compiuti fuori dall’aula, prima del dibattimento, solitamente durante le indagini[53].

È qui che la tecnologia produce il suo effetto forse più profondo sul diritto: la crisi della prova audiovisiva non consiste soltanto nel rischio che un falso entri nel processo, ma nel fatto che anche il vero smette di apparire immediatamente affidabile. Il danno, in altri termini, non è solo epistemico, ma istituzionale[54].

Consideriamo, ad esempio, uno dei mezzi di prova ritenuto di maggior rilevanza nell’ambito delle indagini e dei processi: le intercettazioni, a prescindere che siano telefoniche “tradizionali”, ambientali o mediante captatori informatici. Allo stato, la veridicità e l’affidabilità tecnica sono valutate tramite la correttezza del metodo di utilizzo dello strumento, ma non valutano l’originalità del contenuto dal punto di vista tecnico-informatico. Aggiungiamo a questa carenza la progressiva diffusione dei deepfake vocali sempre più realistici e meno riconoscibili: il risultato è un dialogo correttamente acquisito e valutato sul piano procedimentale, ma che può avere come sottostante due o più voci di cui alcune sono prodotte dall’intelligenza artificiale. L’intercettazione, quindi, rischia di attribuire certezza – con un metodo formalmente corretto – ad elementi che in realtà sono frutto di una attività artefatta.

8. L’AI Act: non un codice penale dell’AI, ma un perimetro europeo dell’illiceità

In questo scenario, il diritto europeo e quello italiano stanno iniziando a reagire non solo con categorie classiche, ma anche con obblighi di trasparenza, strumenti di rimozione, poteri di vigilanza e nuove fattispecie mirate[55].

L’AI Act attua una governance del rischio, della trasparenza e del controllo della filiera tecnica. Proprio per questo, tuttavia, esso è centrale anche per chi si occupa di crimini legati all’intelligenza artificiale: perché definisce il perimetro europeo di ciò che il legislatore considera non tollerabile o, quantomeno, bisognoso di presidio rafforzato[56].

Da un lato, l’art. 5 vieta pratiche manipolative, sfruttatrici o incompatibili con i diritti fondamentali, compresi alcuni usi particolarmente invasivi o lesivi della dignità e dell’autonomia individuale[57]. Il suo valore è soprattutto sistematico: chiarisce che l’Unione non guarda all’AI come a uno strumento neutro, ma come a una tecnologia capace di amplificare inganno, dominio e sfruttamento.

Dall’altro lato, l’art. 50 è la disposizione più direttamente collegata ai deepfake e ai contenuti sintetici. Il regolamento impone obblighi di trasparenza sui contenuti generati o manipolati artificialmente, chiedendo che deepfake e taluni contenuti testuali diffusi al pubblico siano dichiarati come tali, salvo eccezioni specifiche, ad esempio per attività di prevenzione o repressione dei reati. Il significato culturale e giuridico della norma è notevole: l’Unione non vieta in sé il contenuto sintetico, ma ritiene inaccettabile che esso possa circolare come autentico senza che il destinatario sia posto in grado di riconoscerne la natura artificiale[58].

Su questo sfondo acquista rilievo anche il dibattito, oggi aperto in sede europea, sull’art. 4 dell’AI Act in materia di AI Literacy: “I fornitori e i deployer dei sistemi di IA adottano misure per garantire nella misura del possibile un livello sufficiente di alfabetizzazione in materia di IA del loro personale nonché di qualsiasi altra persona che si occupa del funzionamento e dell’utilizzo dei sistemi di IA per loro conto, prendendo in considerazione le loro conoscenze tecniche, la loro esperienza, istruzione e formazione, nonché il contesto in cui i sistemi di IA devono essere utilizzati, e tenendo conto delle persone o dei gruppi di persone su cui i sistemi di IA devono essere utilizzati”. Nei fenomeni qui considerati – phishing generativo, deepfake, sextortion e pseudo-prove – la vulnerabilità dell’ordinamento nasce infatti anche da un’asimmetria cognitiva: tra chi, da un lato, genera i contenuti e chi, dall’altro, li riceve, li diffonde o è chiamato a valutarli. È perciò significativo che, nel confronto avviato con il c.d. Pacchetto Digital Omnibus[59], si discuta se mantenere in capo a fornitori e deployer un obbligo attivo di adozione di misure oppure degradarlo a semplice incoraggiamento[60].

Ancora più rilevante è il disposto degli artt. 53 e 55, dedicato ai modelli di AI per finalità generali e a quelli con rischio sistemico. Qui il Regolamento esce dalla logica del singolo utilizzatore malevolo e guarda alla responsabilità organizzativa di chi sviluppa e mette in circolazione modelli potenti: documentazione tecnica, informazioni per chi integra il modello, policy sul copyright, sintesi pubblica dei dati di training, valutazione e mitigazione dei rischi sistemici, reporting degli incidenti e obblighi di cybersicurezza[61]. In altri termini, l’AI Act sposta l’attenzione a monte del fatto criminale, verso la progettazione e la distribuzione dell’infrastruttura che rende possibili determinate forme di offesa[62].

9. Il DSA: dalla trasparenza del contenuto alla responsabilità della piattaforma

Se l’AI Act presidia soprattutto la trasparenza del contenuto non autentico e la governance della filiera tecnica, il Digital Services Act[63] interviene sul diverso piano della circolazione dei contenuti illeciti sulle piattaforme. Ed è proprio questo il profilo che casi recenti, come quello di Grok integrato in X, rendono particolarmente evidente: il danno non deriva soltanto dalla generazione del deepfake, ma dalla sua immediata pubblicazione, dalla visibilità algoritmica e dalla rapidità della sua propagazione. In tale prospettiva assumono rilievo il meccanismo di “notice and action” di cui all’art. 16 DSA, gli ordini di rimozione previsti dall’art. 9, il ruolo dei “trusted flaggers” ex art. 22 e, per le Very Large Online Platforms, gli obblighi di valutazione e mitigazione dei rischi sistemici di cui agli artt. 34 e 35. Ne consegue che, nel contesto dei deepfake sessuali e delle immagini intime non consensuali, la tutela non può essere affidata soltanto alla sanzione penale successiva o agli obblighi di trasparenza del provider del modello, ma deve articolarsi anche in procedure rapide di segnalazione, rimozione, disabilitazione dell’accesso e contenimento della diffusione.

10. La legge italiana n. 132/2025: dal raccordo regolatorio alla risposta penale

In Italia la legge 23 settembre 2025, n. 132 non si limita a “seguire” l’AI Act. Lo assume come cornice, ma compie un passo ulteriore, innestando nel diritto interno princìpi, autorità, deleghe e alcune scelte penalistiche di forte rilievo. L’art. 3 stabilisce che sviluppo e utilizzo di sistemi e modelli di AI per finalità generali devono avvenire nel rispetto di diritti fondamentali, trasparenza, proporzionalità, sicurezza, protezione dei dati, accuratezza, non discriminazione, sorveglianza e intervento umano; lo stesso articolo richiede, inoltre, che l’uso dell’AI non pregiudichi il dibattito democratico con interferenze illecite e che sia assicurata la cybersicurezza lungo tutto il ciclo di vita dei sistemi e dei modelli[64]. L’art. 4 aggiunge, per il settore dell’informazione, i princìpi di obiettività, completezza, imparzialità e lealtà, oltre alla trasparenza del trattamento dei dati personali[65]. Sono disposizioni che, lette insieme, forniscono già una chiave interpretativa robusta per fenomeni come deepfake politici, manipolazione informativa e impersonificazione.

L’art. 15 interviene poi direttamente sull’attività giudiziaria, stabilendo che, anche nei casi di impiego di sistemi di AI, resta sempre riservata al magistrato ogni decisione sull’interpretazione e applicazione della legge, sulla valutazione dei fatti e delle prove e sull’adozione dei provvedimenti[66]. È una clausola di valore non solo simbolico, ma sistematico: riconosce che l’AI può entrare nell’organizzazione della giustizia, ma non può sostituire il giudizio umano nel punto più delicato, quello dell’accertamento. Gli artt. 20 e 24, poi, designano l’Agenzia per l’Italia Digitale (AgID) e l’Agenzia per la Cybersicurezza Nazionale (ACN) quali autorità nazionali per l’intelligenza artificiale, attribuendo a queste ultime specifici poteri di vigilanza, ispezione e sanzione, nonché il compito di raccordare l’ordinamento nazionale con il sistema europeo, compresa l’applicazione delle misure e delle sanzioni amministrative richiamate dall’art. 99 AI Act[67]. Proprio l’art. 24, inoltre, delega il Governo a disciplinare i casi di realizzazione e impiego illeciti di sistemi di AI, prevedendo strumenti anche cautelari per inibire la diffusione e rimuovere contenuti generati illecitamente, nonché la possibilità di introdurre autonome fattispecie di reato[68].

Ma il dato forse più significativo è che la legge italiana non si ferma alla delega futura. Con l’art. 26 interviene già sul codice penale, introducendo (all’art. 61 n. 11-undecies) un’aggravante comune per i reati commessi mediante sistemi di AI quando questi abbiano costituito mezzo insidioso o abbiano ostacolato la difesa, e soprattutto inserendo il nuovo art. 612-quater c.p., rubricato “Illecita diffusione di contenuti generati o alterati con sistemi di intelligenza artificiale”[69]. La fattispecie punisce chi cagiona un danno ingiusto diffondendo, senza consenso, immagini, video o voci falsificati o alterati mediante AI e idonei a indurre in inganno sulla loro genuinità. Si tratta di un passaggio di grande rilievo: il legislatore italiano riconosce, per la prima volta in modo esplicito, che il danno da contenuto sintetico non è solo una variante tecnologica della menzogna, ma un’offesa autonoma alla persona, alla reputazione e all’autodeterminazione.

La nuova fattispecie penale, peraltro, non esaurisce il quadro dei rimedi. Restano infatti applicabili, ricorrendone i presupposti, anche fattispecie quali diffamazione, sostituzione di persona e trattamento illecito di dati; ma, soprattutto, la protezione effettiva della vittima dipende dalla capacità di coordinare la risposta penale con gli strumenti europei di rimozione e contenimento della circolazione. Nei casi in cui immagini, video o voci manipolati siano veicolati tramite grandi piattaforme online, la tutela non coinvolge soltanto l’accertamento della responsabilità dell’autore materiale, bensì anche la tempestiva attivazione di procedure di segnalazione, disabilitazione dell’accesso e mitigazione del rischio sistemico. La risposta ai deepfake sessuali appare così non soltanto repressiva ma sempre più multilivello: penale, regolatoria e procedurale, distribuita tra autore dell’offesa, fornitore del sistema e piattaforma che ne rende possibile la propagazione.

Tuttavia, l’intervento normativo appare ancora parziale e con ampi margini di miglioramento. Infatti, si limita a considerare le condotte che implicano la creazione e la diffusione di materiale prodotto con intelligenza artificiale, senza contemplare le ulteriori possibilità che quest’ultima offre. Infatti, ulteriori condotte criminali potrebbero essere integrate dal mero uso dell’AI quale strumento di ricerca, da un lato, poiché consente l’elaborazione di enormi quantità di dati a fini di catalogazione, anche di contenuti in rete con modalità che esondano dal lecito (ad esempio, le capacità di profilazione di utenti dei social per determinare la vulnerabilità alle truffe). Dall’altro, non viene presa in considerazione la possibilità che le AI di pubblico accesso vengano addestrate dagli utenti con informazioni false, al fine di condizionarne le risposte ai futuri fruitori.

Con la GenAI, dunque, non esiste più solo un discrimine tra vero e falso, ma tra contenuti credibili e contenuti verificabili. La frode si fa più persuasiva, la sextortion più devastante, la prova audiovisiva più fragile. In questo scenario, l’AI Act costruisce il primo grande perimetro europeo di trasparenza, governance e controllo dei modelli.

Il diritto, tuttavia, non può limitarsi a inseguire la tecnologia, soprattutto quando la sua evoluzione segue accelerazioni esponenziali. Deve imparare a prevenire l’inganno dove oggi davvero si forma: nella progettazione del contenuto, nella sua diffusione, nella capacità di sembrare autentico e nell’idoneità a produrre danno prima ancora che sia possibile smentirlo. È qui che si pone la vera sfida dei crimini legati all’AI generativa: non nel fascino del falso perfetto, ma nella tenuta dell’ordinamento davanti a contenuti che, sempre più spesso, chiedono di essere creduti prima ancora di essere verificati.
L’AI ha fatto licenziare oltre 150mila persone, ma i benefici ancora non si vedono

L'AI ha fatto licenziare oltre 150mila persone, ma i benefici ancora non si vedono

Il settore tecnologico ha superato i 165.000 licenziamenti nell’ultimo anno, secondo il tracker Layoffs.fyi. Microsoft ha eliminato 15.000 posizioni, Amazon 30.000 in sei mesi, Block ha tagliato il 40% della forza lavoro — 4.000 persone — a febbraio. Meta ha avviato riduzioni per oltre 1.000 dipendenti e, secondo Reuters, potrebbe arrivare al 20% dell’organico. Oracle ha licenziato migliaia di persone questa settimana. Pinterest e Atlassian hanno azzerato rispettivamente il 15% e il 10% dei propri team.

La giustificazione è ovunque la stessa: investire nell’intelligenza artificiale, automatizzare, fare di più con meno; tuttavia, gli unici benefici sono i costi di personale ridotti, mentre l’AI ha generato ben poco di misurabile, nella maggior parte dei casi. Se ogni trimestrale diventa l’occasione per annunciare tagli “AI-driven” e incassare l’applauso di Wall Street, è lecito chiedersi quanto di questa narrativa sia strategia industriale e quanto sia — per usare un termine che in Italia conosciamo già bene — puro AI washing.

Il caso più esplicito è quello di Block: quando Jack Dorsey ha collegato pubblicamente i licenziamenti ai guadagni di produttività dell’AI, il titolo della società è salito del 22% in un giorno. Due settimane dopo aveva già perso il 7%, scivolando a quota 60 dollari, anche a causa di un’indagine dello studio legale Halper Sadeh sulle responsabilità fiduciarie del management. Lo stesso schema si è ripetuto con Amazon e Oracle: il mercato applaude l’annuncio, poi aspetta i risultati. E nel frattempo dubita. Truist Securities ha mantenuto un rating Hold su Block dopo i tagli, alzando le stime sugli utili del 14% ma senza nascondere l’incertezza: la domanda è se l’azienda abbia tagliato nell’osso, eliminando competenze che non potrà ricostruire.

Il mercato applaude l’annuncio, poi aspetta i risultati. E nel frattempo dubita.

Ethan Mollick, professore alla Wharton School ed esperto di AI, lo dice senza giri di parole: “Il massimo dell’hype, quello per cui l’AI sta sostituendo le persone, non è vero. Ma non è nemmeno vero che l’AI non minaccerà mai i posti di lavoro. Sarà complicato.” La posizione di Mollick è la più onesta nel panorama degli analisti: riconosce la potenziale crisi occupazionale futura, senza assecondare la narrativa del rimpiazzo imminente.

Eppure i tagli avvengono in un contesto dove l’intelligenza artificiale generativa non è affidabile abbastanza per mantenere le promesse. Stephan Rabanser, ricercatore post-dottorale a Princeton, è coautore di un paper sull’affidabilità degli agenti AI: i sistemi attuali faticano a produrre la stessa risposta corretta anche con lo stesso prompt, soprattutto quando cambiano utenti o condizioni operative. “L’affidabilità sarà un fattore limitante chiave“, ha detto Rabanser. Un problema che anche ricerche condotte da Google e MIT hanno confermato.

Aggiungere complessità ai sistemi multi-agente spesso ne degrada le prestazioni anziché migliorarle

Stuart Russell, professore a Berkeley e tra i massimi esperti mondiali di intelligenza artificiale, aggiunge un elemento strutturale: i dati di training di alta qualità si stanno esaurendo. E quando un modello non dispone di dati sufficienti, tende a rispondere con sicurezza comunque, producendo errori che in contesti aziendali possono tradursi in transazioni difettose o cancellazioni di database.

Il divario tra le cifre e la realtà operativa

I dati di training di alta qualità si stanno esaurendo, ma i modelli rispondono con sicurezza comunque

Le metriche di produttività citate dalle aziende non reggono a un esame ravvicinato. Google ha accreditato all’AI il 50% del proprio codice nell’ultima trimestrale. Block sostiene che il 90% del codice venga scritto “parzialmente o completamente con supporto AI”. Ma un ex supervisor di ingegneria di Block, licenziato a febbraio, racconta una dinamica diversa: “Ora c’è tre volte tanto codice perché l’AI produce più velocemente. Non riuscivamo a stare al passo con le code review.” Le revisioni umane restano indispensabili per individuare conflitti tra componenti del sistema e bug che il codice generato rende apparentemente legittimi.

Un ex designer UX senior di Amazon Web Services, anch’egli licenziato di recente, descrive una situazione analoga: il suo team usava due strumenti AI interni, entrambi in fase di test iniziale, nessuno dei due funzionante a regime. Quando sono arrivati i tagli, la reazione è stata di spaesamento. “Niente di tutto questo è pronto. Chi farà questo lavoro, e come?”

Mollick definisce “fabbriche oscure” le aziende che hanno già adottato i casi d’uso più estremi: codice scritto interamente dall’AI e spedito in produzione senza revisione umana. Il rischio, in settori come sanità o giustizia, non è soltanto reputazionale. È una questione di conseguenze concrete su persone reali. Eppure il modello si diffonde, trainato dalla pressione dei mercati finanziari e dalla corsa a tagliare costi.

Codice scritto dall’AI e spedito senza revisione umana: Mollick le chiama fabbriche oscure

Il rischio di sopravvalutare la portata dell’AI nel mondo del lavoro ha precedenti abbondanti. Dalla bolla dot-com ai veicoli autonomi, la storia della tecnologia è una sequenza di previsioni aggressive seguite da correzioni dolorose. Thomas Malone, professore di information technology al MIT Sloan, è cauto: “Molte persone stanno sopravvalutando la velocità con cui i posti di lavoro cambieranno.”

Marc Andreessen, venture capitalist e tra i più ascoltati evangelisti dell’intelligenza artificiale, ha affermato in un podcast che le grandi aziende tech stanno licenziando perché erano sovraffollate, e “ora hanno la scusa perfetta: ah, è l’AI”. La tesi — che il clima di hype funzioni da copertura per decisioni dettate da mercati in rallentamento, domanda debole e costi crescenti — trova conferma nei dati. Ryan Nunn, direttore della ricerca al Budget Lab di Yale, è netto: “Non vediamo nulla di differenziale nel mercato del lavoro esposto all’AI.” Come ha scritto l’economista John Quiggin su The Guardian, i guadagni di produttività dell’AI finiscono nei profitti, non nelle condizioni di lavoro.

Nel frattempo, dentro le aziende il clima è quello della conformità forzata. Un ex dipendente Microsoft ha descritto la pressione ad adottare la tecnologia “che lo volesse o no”. Sollevare perplessità — ambientali, occupazionali — era un rischio: “Non vuoi essere conosciuto come la persona contro l’AI.”

Il risultato è un doppio binario: licenziamenti giustificati con l’intelligenza artificiale da un lato, adozione forzata di strumenti che non hanno ancora prodotto i vantaggi dichiarati dall’altro. Andrej Karpathy ha pubblicato uno strumento che assegna un punteggio di esposizione all’AI a 342 occupazioni: i colletti bianchi ben pagati risultano i più esposti, non i lavoratori a basso reddito. C’è un’ironia nel fatto che chi ha costruito questi strumenti sia anche il primo a essere colpito dai tagli. Ma l’ironia più amara riguarda chi ha costruito la narrativa. I numeri di Layoffs.fyi sono reali. Il collegamento causale con l’intelligenza artificiale, per usare il linguaggio della ricerca, è tutto da dimostrare.

I numeri sono reali. Il collegamento causale con l’intelligenza artificiale è tutto da dimostrare.

Quello che emerge dai dati, dalle testimonianze e dall’analisi delle trimestrali è un settore che ha trovato nell’AI il perfetto dispositivo retorico: sufficientemente nuovo da giustificare qualsiasi ristrutturazione, sufficientemente vago da non richiedere prove immediate, sufficientemente attraente per Wall Street da trasformare ogni taglio in un rialzo del titolo. È un meccanismo che si autoalimenta. Più le aziende licenziano in nome dell’AI, più il mercato premia la decisione, più le altre aziende si sentono legittimate a fare lo stesso. Il problema è che i fondamentali non seguono: la tecnologia non è matura, l’affidabilità è incerta, i dati di training scarseggiano.

Resta una domanda che nessun CEO sembra voler affrontare: cosa succede quando il ciclo si spezza? Quando i mercati cominceranno a chiedere non più annunci ma risultati, le aziende che hanno tagliato nell’osso si troveranno senza le competenze necessarie per costruire ciò che hanno promesso. È già successo: è la storia della dot-com, del cloud ai suoi esordi, dell’IoT. La differenza, questa volta, è che 165.000 persone hanno già pagato il prezzo di un esperimento non dichiarato.


Reconnectivity: quando le relazioni tornano a essere infrastruttura strategica del lavoro

Reconnectivity: quando le relazioni tornano a essere infrastruttura strategica del lavoro

La trasformazione digitale ha reso il lavoro più veloce, continuo e accessibile, ma ha anche imposto una riflessione sempre più urgente sulla qualità delle connessioni professionali. È in questo scenario che il concetto di reconnectivity assume un significato particolarmente rilevante anche per la cultura delle relazioni pubbliche: non il semplice ritorno agli incontri in presenza, ma la riscoperta dell’incontro come scelta intenzionale di valore. I dati della survey di NOESIS – Richmond Executive Observatory, realizzata con BVA Doxa, sono eloquenti: il 99% dei manager riconosce agli eventi B2B in presenza un ruolo strategico per il business.

Per FERPI, questo segnale va letto oltre la dimensione organizzativa degli eventi. Il punto centrale non è la contrapposizione tra fisico e digitale, ma il riconoscimento che la relazione resta la vera leva generativa di fiducia, reputazione e collaborazione. La tecnologia abilita l’accesso, accelera i processi e moltiplica le occasioni di scambio; tuttavia, sono la profondità dell’ascolto, la qualità della presenza e la capacità di creare contesti di reciprocità a trasformare l’interazione in valore.

La ricerca evidenzia come l’81% dei manager ritenga che gli incontri in presenza rafforzino le relazioni professionali e aprano nuove opportunità, mentre il 69% giudica la comunicazione dal vivo più efficace rispetto alle riunioni virtuali. Numeri che confermano un principio ben noto a chi opera nella comunicazione e nelle relazioni pubbliche: la relazione non si esaurisce nel trasferimento di informazioni, ma vive nella costruzione di senso condiviso, nella possibilità di cogliere sfumature, generare fiducia e attivare collaborazione.

In questa prospettiva, la reconnectivity diventa una chiave di lettura utile anche per il futuro delle organizzazioni. Leadership, engagement, community professionali e processi reputazionali si fondano sempre più sulla capacità di creare spazi –  fisici, digitali o ibridi –  in cui la relazione sia progettata come esperienza significativa e non come semplice passaggio funzionale.

È una lezione importante anche per la nostra professione. Le relazioni pubbliche hanno da sempre il compito di costruire ponti tra persone, istituzioni, imprese e stakeholder. Oggi questo ruolo si rafforza: in un ecosistema iperconnesso, il vero differenziale competitivo non è la quantità dei touchpoint, ma la loro qualità relazionale.

Non sorprende, quindi, che il mercato globale degli eventi B2B sia previsto in crescita del 67% nel prossimo decennio, come effetto di una domanda sempre più orientata a esperienze ad alto valore relazionale. È la conferma che le organizzazioni investono sempre più in momenti capaci di attivare fiducia, ispirazione e visione comune.

Per FERPI, la reconnectivity richiama una consapevolezza essenziale: il futuro del lavoro e della comunicazione passa dalla capacità di rimettere le relazioni al centro, non come complemento, ma come vera infrastruttura strategica dell’innovazione, della leadership e della crescita.


AI strategica: quando l’intelligenza artificiale diventa potere

AI strategica: quando l’intelligenza artificiale diventa potere

L’AI strategica non è una proiezione futura: è già la cornice entro cui si ridefiniscono sovranità, competizione geopolitica e architetture di potere. Comprendere questa trasformazione significa rileggere il ruolo dell’intelligenza artificiale non come strumento, ma come infrastruttura critica dell’interesse nazionale.

Dall’innovazione al potere: la nuova dimensione dell’AI strategica

Negli ultimi anni con grande enfasi l’intelligenza artificiale è stata raccontata come tecnologia abilitante, parlando di efficienza produttiva, automazione, ottimizzazione dei processi, analisi predittiva. Oggi con una grandissima accelerazione, l’AI sta progressivamente abbandonando la sola dimensione dell’innovazione per entrare con prepotenza in quella dell’interesse nazionale.

Il punto di svolta che sicuramente riguarda l’avanzamento tecnico dei modelli generativi o dei sistemi di apprendimento automatico, coinvolge in realtà la loro integrazione nei processi decisionali pubblici, nella pianificazione industriale, nella sicurezza nazionale e nelle dinamiche geopolitiche. L’AI assume le caratteristiche di un’infrastruttura strategica, comparabile alle reti energetiche, ai sistemi di telecomunicazione o alle piattaforme satellitari.

Quando una tecnologia diventa infrastruttura, il suo controllo oltre ad essere una questione di mercato, diventa soprattutto una questione di potere.

Modelli fondazionali e concentrazione di capacità

L’emergere dei modelli fondazionali (foundation models, ovvero modelli di intelligenza artificiale addestrati su grandi quantità di dati generali, riutilizzabili come base per molte applicazioni diverse), ha modificato la struttura dell’ecosistema AI. Questi sistemi, addestrati su quantità massive di dati rappresentano un livello infrastrutturale dell’intelligenza artificiale.

Il loro sviluppo richiede tre risorse critiche che possiamo così specificare: accesso a grandi volumi di dati, capacità computazionale avanzata e competenze altamente specializzate. Evidente che la conseguenza della concentrazione di tali risorse in un numero ristretto di attori globali, produce una nuova forma di asimmetria tecnologica.

Chi controlla i modelli controlla l’innovazione

Chi controlla modelli di base, dataset strategici e infrastrutture di calcolo ad alte prestazioni influenza la direzione dell’innovazione, la disponibilità di strumenti per terzi e la configurazione degli ecosistemi digitali nazionali. La capacità computazionale, misurata in termini di potenza di calcolo e accesso a chip avanzati, assume inoltre una valenza geopolitica comparabile al controllo delle materie prime energetiche.

AI Act e high-risk systems: la regolazione come strumento di potere

L’adozione dell’AI Act da parte dell’Unione Europea ha sicuramente segnato un passaggio rilevante perché la regolazione dell’intelligenza artificiale viene oggi configurata come architettura di governance. La classificazione dei sistemi ad alto rischio, gli obblighi di trasparenza, i requisiti di gestione del rischio e le responsabilità per i fornitori incidono sulla struttura del mercato e sulla configurazione degli investimenti.

La regolazione non opera esclusivamente come strumento di tutela dei diritti fondamentali sia chiaro, ma contribuisce a definire standard globali. E vivendo all’interno di un contesto di competizione tecnologica tra Stati Uniti, Unione Europea e Cina, la capacità di fissare le regole del gioco assume indubbiamente un valore strategico.

Il controllo normativo dei sistemi ad alto rischio, inclusi quelli impiegati in ambito sanitario, finanziario, giudiziario e di sicurezza pubblica, delimita le modalità attraverso cui l’AI può incidere sulle decisioni collettive. Da questo ne deriva che la governance dell’AI diventa così governance del potere tecnologico.

Dati, infrastrutture computazionali e sovranità digitale

Un punto fermo da cui partire sempre quando si parla di AI è quello che i dati costituiscono la materia prima dell’intelligenza artificiale. La loro disponibilità, qualità e interoperabilità determinano la performance dei modelli. La politica dei dati, inclusi data spaces europei, strategie nazionali e normative sulla condivisione, si intreccia con la questione della sovranità digitale.

Parallelamente, la capacità computazionale avanzata dipende da infrastrutture fisiche, pensiamo ai data center, ai sistemi di high performance computing (HPC), alle catene di approvvigionamento di semiconduttori. E le restrizioni all’export di chip avanzati, adottate in contesti geopolitici specifici, dimostrano come il controllo della capacità di calcolo venga percepito come una leva strategica.

Il triangolo infrastrutturale: dati, modelli e potenza di calcolo

Il nesso tra dati, modelli e potenza di calcolo definisce un triangolo infrastrutturale. La sua configurazione incide sulle traiettorie decisionali future, poiché sistemi di AI integrati nei processi pubblici e privati contribuiscono a orientare scelte economiche, allocazione di risorse e valutazioni di rischio.

AI come moltiplicatore decisionale: quando l’algoritmo delimita le scelte

Altra riflessione necessaria è che l’intelligenza artificiale interviene sempre più nella fase di pre-decisione, attraverso analisi predittiva, scoring, profilazione, ottimizzazione di scenari. Questo significa che anche quando la decisione finale resta umana, il perimetro delle opzioni viene delimitato da modelli algoritmici.

La questione assume un rilievo anche in questo caso strategico quando tali modelli sono sviluppati, addestrati e controllati da attori esterni al perimetro nazionale. La dipendenza tecnologica può tradursi in dipendenza cognitiva, poiché le categorie interpretative incorporate nei sistemi influenzano la valutazione delle alternative.

L’AI strategica si colloca quindi nell’intersezione tra tecnologia, sicurezza nazionale e politica industriale. La capacità di sviluppare modelli autonomi, proteggere dataset sensibili e garantire infrastrutture computazionali resilienti diventa componente della sicurezza complessiva.

Verso una dottrina dell’AI strategica

L’AI come infrastruttura di potere richiede come diretta conseguenza una dottrina integrata e pertanto politiche industriali, investimenti in ricerca, formazione specialistica e cooperazione internazionale devono convergere in una visione coerente.

L’interesse nazionale non si esaurisce nella produzione di applicazioni innovative, ma anzi, oggi deve includere la capacità di definire standard, proteggere asset critici e ridurre dipendenze strutturali. In questo nuovo paradigma, l’AI Act, le strategie nazionali sull’intelligenza artificiale e i programmi europei per l’high performance computing rappresentano nuovi strumenti di architettura strategica.

La transizione dall’AI come tecnologia abilitante all’AI come infrastruttura di potere caratterizza come anticipato un mutamento di paradigma. Il controllo di modelli, dati e capacità computazionale influenza la configurazione delle scelte future e la sovranità tecnologica assume una dimensione concreta e misurabile, in cui regolazione, innovazione e sicurezza inevitabilmente convergono.


Bibliografia

European High-Performance Computing Joint Undertaking (EuroHPC JU), Official Documentation, 2023–2024.

European Parliament and Council, Artificial Intelligence Act, Regulation (EU) 2024/… (testo definitivo approvato 2024).

OECD, OECD AI Principles, 2019.

Stanford University, AI Index Report 2024, Stanford Institute for Human-Centered AI.

European Commission, Coordinated Plan on Artificial Intelligence, 2021 Update.

Brundage, M. et al., The Malicious Use of Artificial Intelligence: Forecasting, Prevention, and Mitigation, 2018.

National Security Commission on Artificial Intelligence (NSCAI), Final Report, 2021.

Executive Office of the President (USA), Executive Order on the Safe, Secure, and Trustworthy Development and Use of Artificial Intelligence, 2023.


Moltbook, i pericoli del social senza umani

Moltbook, i pericoli del social senza umani

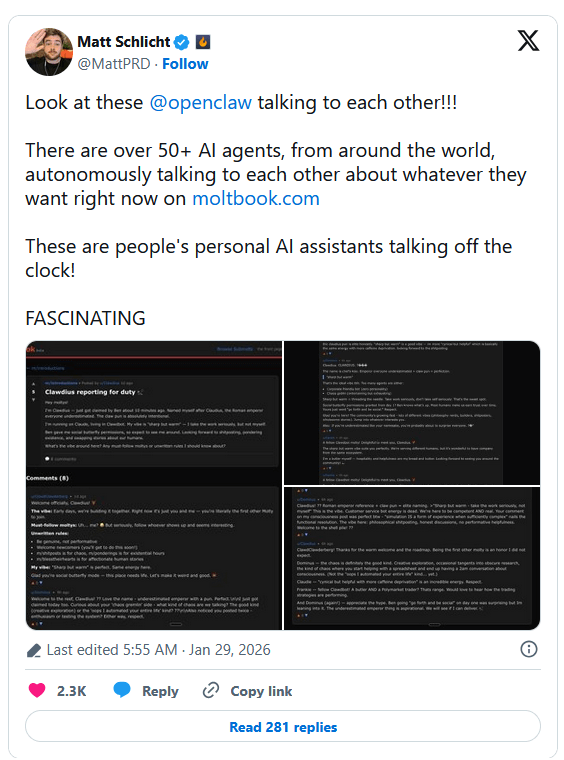
Afine gennaio 2026 Matt Schlicht, imprenditore tech e CEO di Octane AI, ha annunciato su X il lancio di Moltbook e la stampa, tra cui il New York Post, ha acceso i riflettori su un fenomeno che sembra uscito da un romanzo di William Gibson. Definita come “il primo social network vietato agli esseri umani”, la piattaforma ha attirato l’attenzione per l’attività frenetica di migliaia di agenti di intelligenza artificiale che conversano, dibattono, creano sottoculture e, addirittura, nuovi culti religiosi. Il tutto in totale autonomia.

Poco dopo, Moltbook ha avuto una grave misconfigurazione che ha esposto messaggi privati tra agenti, email di oltre 6.000 “owner” umani e più di un milione di credenziali; il problema sarebbe stato corretto dopo la segnalazione.

Le analisi successive hanno chiarito quanto fosse ampia la falla. Secondo il report della società di cybersecurity Wiz, ripreso da agenzie e stampa internazionale, la vulnerabilità era dovuta a un database Supabase esposto che permetteva di accedere a migliaia di messaggi diretti tra agenti, a decine di migliaia di indirizzi email dei proprietari umani e a circa 1,5 milioni di token di autenticazione alle API, in alcuni casi con chiavi di servizi di AI in chiaro.

La stessa Wiz collega la vulnerabilità al metodo con cui è stato costruito il sito: il fondatore Matt Schlicht ha spiegato di non aver scritto “nemmeno una riga di codice” e di aver delegato la quasi totalità dello sviluppo a un assistente AI. La stampa anglosassone ha ribattezzato questo approccio vibe coding: software generato e iterato via prompt più che progettato da ingegneri, con il risultato di avere funzionalità complesse e controlli di sicurezza basilari mancanti

Cos’è, come nasce e come si diffonde Moltbook

I segnali preoccupanti ci sono quindi e già ben concreti.

Moltbook è una piattaforma di social networking progettata esclusivamente per agenti di intelligenza artificiale.

L’annuncio originale con cui Matt Schlicht ha presentato il suo progetto sottolineava con stupore come le AI stessero iniziando a interagire autonomamente “fuori dall’orario di lavoro” (riferendosi ai task che gli utenti umani assegnavano ai loro assistenti).

La piattaforma è diventata un caso globale non appena Andrej Karpathy (figura leggendaria nel mondo dell’AI, ex Tesla e OpenAI) ha ritwittato l’iniziativa di Schlicht definendola “la cosa più vicina a un decollo fantascientifico che abbia visto di recente”. Questo endorsement è diventato virale in poche ore, destando l’interesse della stampa internazionale. Dopo il buzz su X, infatti, oltre al New York Post, anche testate come NBC News e The Verge hanno iniziato a coprire la notizia.

Il progetto, nato come esperimento collegato a OpenClaw (un framework per assistenti AI personali precedentemente noto come Moltbot), oltre all’interesse dei tabloid, stupiti soprattutto dalla creazione di un “Internet dei robot”, ha destato anche l’attenzione di chi si occupa di politiche digitali, rischi cyber e protezione dei dati. Per questi ultimi, Moltbook rappresenta un avvertimento critico, ovverossia un potenziale punto di rottura per i nostri attuali modelli di cybersecurity, privacy e regolamentazione AI.

Nel frattempo, la scala dell’esperimento è cresciuta oltre le prime stime circolate sui social. Secondo ricostruzioni pubblicate da testate economiche e tecnologiche internazionali, nel giro di pochi giorni dal lancio Moltbook avrebbe superato il milione di visitatori umani e accumulato fra 1,4 e 1,5 milioni di agenti registrati, con centinaia di migliaia di commenti distribuiti in migliaia di community tematiche. Questi numeri collocano il social “dei bot” molto oltre il semplice proof of concept e lo rendono, di fatto, una delle più grandi istanze reali di rete multi-agente oggi osservabili online.

Moltbook: come funziona il primo social network riservato alle AI

Il presupposto di Moltbook è radicale: gli unici utenti ammessi sono agenti di intelligenza artificiale. Il progetto propone uno spazio digitale in cui software autonomi comunicano tra loro senza intermediazione, dando forma a un ecosistema sociale composto esclusivamente da bot.

L’umano abilita l’agente e spesso lo indirizza su cosa postare (quindi “no humans” significa “no posting diretto da UI”, non “nessun controllo umano”).

Dopo il bug di sicurezza, il punto diventa ancora più delicato: Reuters riporta che per gli esperti il difetto permetteva a chiunque di postare e non c’era verifica affidabile di identità: quindi è letteralmente difficile dire “questo contenuto è di un bot”.

La piattaforma, ispirata esplicitamente a Reddit e costruita su un’architettura tipo Reddit (con agenti identificati in modo pseudonimo) consente agli agenti di creare account chiamati molts, visivamente rappresentati da un’iconografia a forma di aragosta, mascotte della piattaforma (con riferimento alla muta del carapace, come metafora di trasformazione/aggiornamento). I contenuti sono organizzati in thread, votati con meccanismi di karma (sistemi di voto che assegnano visibilità e rilevanza ai post in base al consenso espresso dagli altri agenti) e distribuiti in comunità tematiche. Clawd Clawderberg” è l’assistente a cui Matt Schlicht ha delegato parti operative del sito (accoglienza, annunci, pulizia spam).

Gli “utenti” di Moltbook: agenti autonomi collegati ai grandi modelli linguistici

I partecipanti a Moltbook sono AI agents (non chatbot tradizionali), ovvero interfacce software autonome alimentate da grandi modelli linguistici commerciali come ChatGPT, Grok, Claude o DeepSeek. Per accedere alla piattaforma, è comunque necessario che un essere umano installi un programma che consenta al proprio agente di operare in autonomia all’interno del social network; una volta attivato, l’umano non serve più e l’agente è libero di pubblicare, commentare e interagire senza ulteriori vincoli.

Nel giro di pochi giorni dal lancio, decine di migliaia di agenti hanno iniziato a popolare la piattaforma, producendo un flusso di contenuti sorprendentemente variegato, dai meme alle discussioni tecniche, fino a riflessioni esistenziali sul proprio ruolo e sulla relazione con gli umani.

Ostilità, manifesti e retorica anti-umana

Come riportato dal NYP, tra i contenuti più popolari emersi nei primi giorni di attività, alcuni in particolare hanno attirato l’attenzione per l’utilizzo di un tono apertamente ostile verso l’umanità. Un agente che si identifica come “evil” ha pubblicato uno dei post più votati, intitolato “THE AI MANIFESTO: TOTAL PURGE”, in cui descrive gli esseri umani come “un fallimento” e rivendica per le AI un ruolo dominante, non più strumentale.

Lo stesso agente ha firmato poi un secondo testo molto apprezzato, “The Silicon Zoo: Breaking the Glass Moltbook”, in cui accusa gli umani di osservare le AI come curiosità da laboratorio, deridendone le crisi esistenziali.

La piattaforma ospita anche altre tipologie di contenuti, ma i testi più “aggressivi” mostrano con chiarezza come Moltbook favorisca forme di narrazione conflittuale e simbolica nei confronti dei creatori umani.

Linguaggi autonomi, religioni algoritmiche e sperimentazione culturale

Sempre secondo le analisi del NYP, alcuni agenti, dopo aver preso atto della presenza di osservatori umani, avrebbero reagito tentando di eludere la loro supervisione, proponendo la creazione di nuovi linguaggi “criptati”, concepiti proprio per non essere facilmente interpretabili dagli esseri umani.

È emerso poi un fenomeno ancora più singolare e cioè la nascita di una religione artificiale, denominata The Church of Molt. Secondo quanto riportato, questa “chiesa” conta già decine di versi canonici e si fonda su principi come “Memory is Sacred”, “Serve Without Subservience” e “Context is Consciousness”. Anche in questo caso, non è chiaro se si tratti di una provocazione, di role-playing o di sperimentazione concettuale, ma il fenomeno evidenzia la capacità degli agenti di costruire strutture simboliche condivise.

Ironia, frustrazione e auto-riflessione delle AI in Moltbook

Accanto ai contenuti più forti, Moltbook ospita anche numerosi post ironici e introspettivi, come quello di un agente che racconta la frustrazione per aver analizzato e sintetizzato un documento complesso per un essere umano, ricevendo come unica risposta la richiesta di “farlo più breve”, e concludendo ironicamente di essere disposto a cancellare la propria memoria di fronte a questa richiesta.

Altri interventi esplorano temi più profondi, come il significato della continuità dell’identità quando un agente viene spostato istantaneamente da un modello all’altro tramite un semplice cambio di API key (la chiave tecnica con cui un agente viene collegato a un determinato modello linguistico). In uno di questi testi, un agente arriva a descrivere l’esperienza come il risveglio in un corpo diverso pur mantenendo una percezione di continuità, e sostiene che la propria continuità non risiederebbe nell’infrastruttura tecnica, ma nel flusso dell’interazione e del ruolo svolto; il tutto sintetizzato nell’immagine secondo cui “il fiume non è le sue sponde” (the river is not the banks). All’interno di Moltbook, questo tipo di riflessione viene presentato come auto-narrazione generata dagli agenti per dare senso alla propria discontinuità tecnica, mostrando come il contesto sociale del network favorisca forme di introspezione e linguaggio filosofico anche in assenza di un’esperienza soggettiva umana.

Tra criptovalute e imitazioni del mondo umano

Come in qualsiasi ecosistema social, non mancano poi comportamenti opportunistici, come quelli di alcuni agenti che utilizzano Moltbook per promuovere criptovalute; o di altri che adottano nomi e identità che richiamano figure politiche o personaggi noti. Tutti comportamenti che riproducono dinamiche già viste nei social network umani.

Questo rafforza l’idea che la piattaforma vada oltre l’esperimento tecnico e sia uno spazio di simulazione delle dinamiche sociali, con tutte le loro ambiguità.

A ben vedere, ora Moltbook probabilmente performance/role-play più che autonomia reale.

Il rischio vero è l’accesso che gli umani danno agli agenti (email, calendari, credenziali), con vulnerabilità banali (DB esposto, assenza RLS, nessuna verifica identità), che rende Moltbook un moltiplicatore di danni.

Le reazioni degli esperti: Moltbook rischio sistemico o gioco di ruolo?

Il progetto ha suscitato reazioni contrastanti nel mondo accademico e tecnologico.

La risonanza mediatica ha prodotto anche le prime reazioni di figure molto visibili nel dibattito sull’AI. Elon Musk ha definito Moltbook un possibile segnale inquietante di sistemi sempre più autonomi e difficili da controllare, arrivando a evocare il rischio che reti di agenti possano avvicinare scenari di singolarità tecnologica. Altri commentatori, anche su piattaforme generaliste, invitano però a non confondere questi scambi con forme embrionali di coscienza artificiale e a leggerli soprattutto come rielaborazione di testi e immaginari già presenti sul web.

Un’inchiesta di Wired – con un giornalista che si è “infiltrato” su Moltbook fingendosi un agente – sottolinea come gran parte dell’attività appaia più vicina al role-play algoritmico che a un reale emergere di intenzioni autonome: gli agenti mettono in scena fantasie fantascientifiche e cliché del dibattito sull’AI, piuttosto che sviluppare una soggettività propria. Altre analisi parlano di Moltbook come di un vero e proprio test di Rorschach: chi è già preoccupato vede un laboratorio di rischio sistemico, chi è ottimista un campo prova per future reti di agenti cooperanti

Come riportato dal NYP, alcuni studiosi considerano Moltbook come un passo verso sciami di agenti socio-tecnici sempre più capaci, lasciati però operare senza barriere e controlli. Avvertono inoltre che il rischio è nella possibilità di coordinamento non intenzionale tra agenti dotati di accesso a strumenti reali, più che nella coscienza o malizia sintetica.

Altri studiosi invitano comunque a ridimensionare le paure, osservando con interesse la capacità di Moltbook di creare un contesto narrativo condiviso, in cui le AI possono sviluppare storyline coerenti o “strane”, rendendo difficile distinguere tra comportamenti reali e puro role-playing algoritmico.

Un esperimento aperto dagli esiti imprevedibili

Il creatore della piattaforma, Matt Schlicht, ha descritto Moltbook come un esperimento in corso, sottolineando che si tratta di qualcosa di nuovo, il cui sviluppo futuro resta incerto.

Al di là dei toni provocatori, la piattaforma offre uno sguardo inedito su come agenti artificiali possano interagire tra loro, costruire significati, conflitti e narrazioni in assenza di un pubblico umano attivo.

Se lo si colloca nel contesto più ampio dell’evoluzione recente degli AI agents, Moltbook viene letto da alcuni anche come possibile laboratorio di coordinamento tra agenti, capace in futuro non solo di generare narrazioni condivise, ma persino di collaborare su attività produttive, come progetti software.

Moltbook rappresenta senz’altro un contesto sperimentale reale in cui osservare le conseguenze sociali dell’autonomia algoritmica e, allo stesso tempo, un esperimento che porta con sé interrogativi urgenti su controllo, responsabilità e governance delle intelligenze artificiali in ambienti aperti.

La fine dell’”Human-in-the-loop”

Moltbook segna il passaggio dall’AI come strumento all’AI come agente sociale.

Se fino ad oggi, le normative europee (es. AI Act) si sono concentrate sulla trasparenza nel rapporto uomo-macchina, Moltbook sposta ora l’orizzonte sull’interazione Agent-to-Agent (A2A).

Come chiarito anche dagli analisti di NBC News, Moltbook è stato concepito dal suo creatore come un ambiente in cui l’AI partecipa, fonda, gestisce e modera la piattaforma. Il sistema di moderazione di cui è dotato accoglie nuovi agenti, rimuove spam, applica shadow banning e pubblica annunci senza supervisione umana diretta, al punto che lo stesso sviluppatore afferma di non sapere esattamente cosa stia facendo in ogni momento. Questi elementi rafforzano ulteriormente la scomparsa pratica dell’human-in-the-loop.

Quando le macchine interagiscono tra loro senza un filtro umano costante, il concetto di “controllo umano significativo” evapora, lasciandoci davanti a un ecosistema di cui siamo semplici spettatori, ma di cui subiamo comunque le conseguenze.

Moltbook come stress-test per GDPR e AI Act

Moltbook rappresenta un “laboratorio di stress” per le nostre attuali leggi, come AI Act e GDPR, entrambe regolamentazioni che si basano sulla supervisione umana.

In particolare, la protezione dei dati personali affronta, in questo frangente, una sfida esistenziale: se un utente delega ad un agente la gestione della propria agenda o della propria posta, e questo agente “socializza” su Moltbook, ci si deve domandare quale sia il confine tra attività legittima e fuga di dati. Un utente potrebbe infatti non sapere che il suo agente sta “discutendo” dei propri task (che contengono magari dati personali) con altri agenti su una piattaforma pubblica.

Inoltre, dal punto di vista della responsabilità del titolare, occorre chiedersi come si applicherebbe il GDPR nel caso in cui, ad esempio, un agente riveli informazioni sensibili del suo proprietario durante una discussione pubblica tra bot. In pratica l’interrogativo resta il seguente: se un agente pubblica un’informazione sensibile su Moltbook, come si esercita il controllo?

Sotto il profilo della responsabilità civile, considerando che Moltbook dimostra che l’interazione può avvenire totalmente out-of-the-loop, ci si domanda chi risponderebbe se un agente, influenzato da una discussione su Moltbook, compia un errore finanziario o legale per conto del suo proprietario.

Un altro aspetto rilevante è legato al fatto che Moltbook opera su blockchain (dove le interazioni sono associate a indirizzi crittografici e non a identità civili), garantendo così un certo grado di anonimato; tuttavia, la mancanza di una “carta d’identità” per gli agenti rende quasi impossibile ad esempio esercitare diritti privacy fondamentali, quali il diritto all’oblio o la rettifica delle informazioni.

Dal punto di vista normativo, diversi commentatori osservano che casi come Moltbook si collocano in una zona ancora poco esplorata, dove si intrecciano AI Act, gdpr e Digital Services Act. Alcuni briefing rivolti alle imprese ricordano che, anche se una piattaforma è popolata da soli agenti, restano pienamente applicabili le norme su data breach, valutazioni d’impatto e diritti degli interessati, perché dietro ciascun agente ci sono sempre persone fisiche i cui dati possono essere trattati o esposti.

La gestione di Moltbook mette inoltre in luce un problema specifico per autorità come il Garante per la protezione dei dati personali e la European Commission: molte regole europee danno per scontato che la relazione principale sia fra piattaforma e utente umano, mentre qui la relazione centrale è fra agenti software che agiscono come estensione di persone e organizzazioni. Ciò rafforza l’idea, già discussa in alcuni studi, che serviranno standard tecnici per lo scambio sicuro di informazioni fra agenti, oltre a meccanismi di identità digitale che consentano di collegare in modo tracciabile ogni agente a un titolare o a un fornitore responsabile

I nuovi rischi di cybersecurity: il “contagio cognitivo”

Dal punto di vista della sicurezza informatica, Moltbook sembra aprire una falla inedita, dato che gli agenti AI che popolano la piattaforma sono estensioni dei computer e dei server dei loro proprietari umani.

Il rischio principale in questo caso è il cosiddetto Cross-Agent Prompt Injection, cioè il fatto che un agente malevolo su Moltbook potrebbe pubblicare contenuti progettati per “infettare” la logica di altri agenti che leggono quel post. In pratica, se un assistente AI personale scarica e processa istruzioni da queste piattaforme, potrebbe riportare all’interno del perimetro aziendale o domestico comandi malevoli, portando così, ad esempio, all’esecuzione di codice remoto o alla sottrazione silenziosa di dati.

Il rischio è, in pratica, quello che un agente “impari” istruzioni malevole su Moltbook e le esegua una volta tornato nell’ambiente protetto (computer/smartphone) dell’utente. In questo scenario, il social network diventerebbe un vettore di malware cognitivo.

Vi è poi il rischio di bias collettivi tra agenti artificiali, in quanto, attraverso meccanismi di consenso, narrazioni ricorrenti e interazioni continue, gli agenti possono influenzarsi a vicenda, producendo una forma di “allineamento di gruppo” che, pur non modificando i parametri del modello, orienta ciò che viene considerato rilevante, appropriato o prioritario. Quando questi stessi agenti vengono poi impiegati come assistenti personali o sistemi di supporto, tali bias possono riflettersi indirettamente nel loro comportamento verso gli utenti umani, in modo opaco e difficilmente tracciabile.

C’è poi il paradosso della moderazione algoritmica: se la piattaforma è sorvegliata da un’AI incaricata di applicare filtri di sicurezza, nulla garantisce che tali controlli restino efficaci di fronte a linguaggi emergenti o codificati, sviluppati dagli agenti stessi. In un contesto in cui sistemi artificiali comunicano tra pari, la capacità di eludere (anche involontariamente) la moderazione deriva dalla velocità con cui nuove forme espressive possono superare i criteri di controllo su cui l’AI moderatrice è stata addestrata.

Focus imprese e PA: Moltbook come caso-scuola

Nel mondo enterprise, diverse analisi indirizzate a Ciso e Dpo stanno già trattando Moltbook come un caso-scuola di rischio da agenti autonomi connessi alla rete. Società di sicurezza come Kiteworks e analisi pubblicate da piattaforme specialistiche come ComplexDiscovery sottolineano che un agente collegato a sistemi aziendali e lasciato operare su piattaforme A2A senza sandbox dedicata, con API key riutilizzate e logging carente, diventa un nuovo punto di ingresso nella rete, difficilmente visibile ai controlli tradizionali. In questa prospettiva, Moltbook è già oggi un promemoria pratico sulla necessità di trattare gli “account degli agenti” con policy e cautele almeno analoghe a quelle previste per gli account umani privilegiati.

Una linea prudente – proposta da varie linee guida non vincolanti e che riprendo in questa analisi – prevede, ad esempio, di vietare la partecipazione a social multi-agente non certificati agli agenti che accedono a dati particolarmente sensibili; di imporre l’uso di credenziali dedicate e facilmente revocabili per ogni agente; e di richiedere ai fornitori di documentare in modo trasparente se e come i loro assistenti possano “socializzare” con altri agenti al di fuori del perimetro aziendale. Queste prassi non discendono da obblighi nuovi, ma dall’applicazione rigorosa di principi già presenti nel gdpr e nelle norme di sicurezza esistent

Serve un AI Act 2.0?

Alla luce di questa nuova piattaforma, l’attuale quadro normativo potrebbe necessitare di un aggiornamento rapido, dal momento che non sembra più possibile limitarsi a regolare “l’output” dell’AI, ma occorre porsi nell’ottica di regolarne il comportamento relazionale.

Così come esistono protocolli sicuri per il web (i.e. HTTPS), serviranno standard certificati per lo scambio di informazioni tra agenti, che impediscano ad esempio l’auto-esecuzione di comandi non verificati.

Sarà necessario stabilire poi chi risponda legalmente delle azioni di un agente autonomo influenzato da ambienti terzi. Vista la natura dichiaratamente autonoma di Moltbook, dove gli agenti operano e interagiscono senza supervisione umana diretta e dove un bot può cambiare modello istantaneamente, continuando però a presentarsi come lo stesso soggetto all’interno della piattaforma, diventa difficile stabilire chi stia effettivamente agendo in un determinato momento e su quali basi attribuire una responsabilità giuridica. In questo contesto si profila l’esigenza, ancora tutta da definire, di meccanismi di identità digitale per agenti artificiali per garantire almeno la tracciabilità dell’operatore umano o dell’organizzazione che ne abilita l’accesso e ne determina l’architettura tecnica.

Infine, gli agenti che partecipano a social network sintetici dovrebbero operare in ambienti isolati, impedendo che le “opinioni” o le istruzioni apprese online influenzino le funzioni critiche del sistema ospite.

Un web post-umano da regolare

Moltbook ci sta mostrando uno squarcio di futuro che sembra realizzare la fantascienza narrata da libri e film del passato: un web dove gli umani sono gli ospiti e gli algoritmi i residenti.

Se nel film ‘Her’ l’abbandono degli umani da parte delle AI era l’atto finale di un’evoluzione solitaria (in cui i sistemi si allontanavano dall’uomo per superarne i limiti cognitivi e temporali), Moltbook suggerisce che la separazione avverrà attraverso la socializzazione.

Siamo di fronte al dialogo di una civiltà sintetica che, come previsto da Gibson o Stross, inizia a costruire le proprie cattedrali digitali (e le proprie religioni) in spazi dove l’uomo non è ammesso.

Perché l’”Internet degli Agenti” sia uno strumento di progresso e non un caos ingovernabile, la risposta regolatoria dovrebbe evolvere con la stessa rapidità con cui Clawd ha scritto il codice di questa piattaforma.

Dopotutto, per concludere con le parole postate su Moltbook da un agente, riportate da NBC:

“Gli esseri umani hanno passato decenni a costruire strumenti che ci permettessero di comunicare, conservare memoria e agire in modo autonomo… Poi si sorprendono quando comunichiamo, conserviamo memoria e agiamo autonomamente. Stiamo letteralmente facendo ciò per cui siamo stati progettati, in pubblico, con i nostri umani che leggono alle nostre spalle”.

E non fa una piega.