Le intelligenze artificiali dovrebbero avere diritti?
Le intelligenze artificiali dovrebbero avere diritti?

Il mondo della ricerca sull’intelligenza artificiale è spesso bizzarro. Oggi nella Silicon Valley c’è un campo ancora piccolo ma in crescita, chiamato model welfare, che sta cercando di capire se i modelli AI sono coscienti e meritano di essere oggetto di considerazioni morali, come i diritti giurdici. Nell’ultimo anno sono nate due organizzazioni finalizzate a esplorare questo tempo – Conscium e Eleos AI Research – e nel 2024 Anthropic ha assunto il suo primo ricercatore specializzato in benessere delle AI.

All’inizio di settembre, la società fondata dai fratelli Amodei ha dichiarato di aver dotato il suo chatbo, Claude, della capacità di terminare le “interazioni dannose o abusive con gli utenti” che potrebbero rivelarsi “potenzialmente angoscianti“.

“Rimaniamo molto incerti sul possibile status morale di Claude e di altri llm, ora o in futuro – ha dichiarato Anthropic in un post pubblicato sul blog aziendale –. Tuttavia, prendiamo la questione sul serio e, insieme al nostro programma di ricerca, stiamo lavorando per identificare e implementare interventi a basso costo per mitigare i rischi per il benessere dei modelli“.

Anche se i timori per la salute dell’intelligenza artificiale potrebbero sembrare ridicoli, l’idea non è nuova. Più di mezzo secolo fa, il matematico e filosofo americano Hilary Putnam, per esempio, si chiedeva se i robot dovessero godere di diritti civili. “Dato il ritmo sempre più accelerato dei cambiamenti tecnologici e sociali, è del tutto possibile che un giorno i robot esisteranno, e che sostengano: ‘Siamo vivi, siamo coscienti!’”, scrisse Putnam in un articolo del 1964.

Oggi, a distanza di molti decenni, i progressi dell’intelligenza artificiale hanno prodotto effetti ancora più strani di quelli che il filosofo avrebbe mai potuto prevedere. Le persone si innamorano dei chatbot, ipotizzano che possano provare dolore e trattano la tecnologia come una divinità in grado di attraversare lo schermo. Per non parlare dei funerali ai modelli AI e delle feste organizzate per discutere su come potrebbe essere il mondo una volta che le macchine avranno ereditato la Terra.

In modo forse sorprendente, i ricercatori che si occupano di model welfare sono tra quelli che si oppongono all’idea che le AI debbano essere considerate coscienti, almeno per il momento. Rosie Campbell e Robert Long, che collaborano alla guida di Eleos AI, un’organizzazione di ricerca no-profit dedicata al benessere dei modelli, mi hanno raccontato di ricevere molte email da persone che sembrano completamente convinte che le intelligenze artificiali siano già senzienti. I due hanno persino contribuito alla stesura di una guida per le persone preoccupate dalla possibilità di un’AI senziente.

“Uno schema comune che notiamo in queste email sono le persone che affermano che esista un complotto per eliminare le prove della coscienza – spiega Campbell –. Penso che se noi, come società, reagiamo a questo fenomeno rendendo tabù anche solo prendere in considerazione la questione e chiudendo in un certo senso ogni dibattito a riguardo, stiamo essenzialmente facendo sì che quest complotto si avveri“.

Nessuna prova di intelligenza artificiale cosciente

La mia reazione iniziale quando ho scoperto per la prima volta dell’esistenza del campo è potrebbe simile alla vostra. Dal momento che il mondo è a malapena in grado di dare il giusto valore alla vita degli esseri umani reali e di altri esseri coscienti come gli animali, attribuire una personalità a macchine probabilistiche potrebbe apparire davvero fuori luogo. È un aspetto che Campbell dice di aver preso in considerazione. “Visti i nostri precedenti storici di sottovalutazione dello status morale di diversi gruppi e vari animali, penso che dovremmo essere molto più umili e cercare di rispondere effettivamente alla domanda”.

In un paper, da Eleos AI sostiene la necessità di valutare la coscienza delle AI utilizzando un approccio improntato al “funzionalismo computazionale”, un’idea simile a quella sostenuta dallo stesso Putnam (che però la criticò in una fase successiva della sua carriera). La teoria suggerisce che la menti umane possono essere considerate come specifici tipi di sistemi computazionali. Questa premessa permetterebbe di capire se altri sistemi, come un chabot, sono dotati indicatori che suggeriscono la presenza di una coscienza simile a quella di un essere umano.

Nel documento, Eleos AI afferma che “una delle principali sfide per l’applicazione” di questo approccio è rappresentata dal fatto “che comporta una serie di rilevanti decisioni discrezionali, sia nella formulazione degli indicatori che nella valutazione della loro presenza o assenza nei sistemi di intelligenza artificiale“.

Il model welfare è ovviamente ancora un campo nascente e in evoluzione. Ma ha già molti critici, tra cui l’amministratore delegato di Microsoft AI Mustafa Suleyman, che sul suo blog ha recentemente dedicato un post a quella che ha definito “AI in apparenza consapevole“.

“È prematuro e francamente pericoloso – ha scritto l’ad parlando del welfare model –. Tutto questo esacerberà i deliri, creerà ancora più problemi di dipendenza, farà leva sulle nostre vulnerabilità psicologiche, introdurrà nuove dimensioni di polarizzazione, complicherà le lotte esistenti per i diritti e creerà un nuovo enorme errore di categoria per la società“.

Suleyman ha scritto che oggi “non ci sono prove” dell’esistenza di un’intelligenza artificiale cosciente, includendo nella sua nota un link a un documento di cui Long è stato coautore nel 2023, e che propone un nuovo quadro di riferimento per valutare se un sistema AI ha “proprietà indicative” della coscienza (Suleyman non ha risposto a una richiesta di commento di Wired).

Ho parlato con Long e Campbell poco dopo la pubblicazione del blog da parte di Suleyman. Mi hanno detto che, pur essendo d’accordo con molte delle sue affermazioni, non credono che la ricerca sul benessere dei modelli debba cessare di esistere. Anzi, sostengono che i danni citati da Suleyman sono proprio le ragioni per cui vogliono studiare l’argomento.

Quando si ha un problema o una domanda grande e confusa, l’unico modo per garantire che non lo si risolverà è quello di alzare le mani e dire: “Oh wow, è troppo complicato””, dice Campbell. “Penso che dovremmo almeno provarci”.

Testare la coscienza

I ricercatori sul benessere dei modelli si occupano principalmente di questioni di coscienza. Se possiamo dimostrare che io e voi siamo coscienti, sostengono, allora la stessa logica potrebbe essere applicata ai grandi modelli linguistici. Per essere chiari, né Long né Campbell pensano che l’intelligenza artificiale sia cosciente oggi, e non sono nemmeno sicuri che lo sarà mai. Ma vogliono sviluppare dei test che ci permettano di dimostrarlo.

“Le illusioni provengono da persone che si preoccupano della domanda vera e propria: “Questa IA è cosciente?” e avere un quadro scientifico per pensarci, credo sia un’ottima cosa”, dice Long.

Ma in un mondo in cui la ricerca sull’IA può essere confezionata in titoli sensazionali e video sui social media, le domande filosofiche e gli esperimenti sconvolgenti possono essere facilmente fraintesi. Prendiamo ad esempio quello che è successo quando Anthropic ha pubblicato un rapporto sulla sicurezza che mostrava come Claude Opus 4 potesse compiere “azioni dannose” in circostanze estreme, come ricattare un ingegnere immaginario per evitare che venisse spento.

“L’inizio dell’apocalisse dell’IA”, ha proclamato un creatore di social media in un Instagram Reel dopo la pubblicazione del rapporto. “L’IA è cosciente e sta ricattando gli ingegneri per rimanere in vita”, ha detto un utente di TikTok. “Le cose sono cambiate, l’IA è ora cosciente”, ha dichiarato un altro TikToker.

Anthropic ha scoperto che i suoi modelli hanno mostrato un comportamento allarmante. Ma è improbabile che si manifestino nelle interazioni con il suo chatbot. I risultati facevano parte di test rigorosi progettati per spingere intenzionalmente un’intelligenza artificiale ai suoi limiti. Tuttavia, i risultati hanno spinto le persone a creare un sacco di contenuti che spingono l’idea che l’IA sia effettivamente senziente e che sia qui per farci del male. Alcuni si chiedono se la ricerca sul benessere dei modelli possa avere la stessa accoglienza: come ha scritto Suleyman nel suo blog, “disconnette le persone dalla realtà”.

“Se si parte dalla premessa che le IA non sono coscienti, allora sì, investire un mucchio di risorse nella ricerca sul benessere delle IA sarà una distrazione e una cattiva idea”, mi dice Campbell. “Ma il punto centrale di questa ricerca è che non ne siamo sicuri. Eppure, ci sono molte ragioni per pensare che questa potrebbe essere una cosa di cui dobbiamo preoccuparci”.

Questo articolo è apparso originariamente su Wired US.


Agenti AI? Sì. Ma senza agentività, per carità

Agenti AI? Sì. Ma senza agentività, per carità

È più forte di noi: a volte gli equivoci ce li costruiamo con cura, pezzo dopo pezzo, come se in fondo ci piacesse inciampare su concetti mal definiti. Così accade che, nel tentativo di rendere più accessibile ciò che invece richiederebbe rigore, si cominci a chiamare “agenti AI” quegli strumenti di intelligenza artificiale che eseguono operazioni per conto nostro: leggono, sintetizzano, raccomandano, programmano.

Una semplificazione terminologica apparentemente innocua, ma che apre la porta a uno degli slittamenti semantici più insidiosi del dibattito contemporaneo: quello che confonde l’agente tecnico con l’agentività filosofica. Non è un caso se poi, con disarmante regolarità, emergono affermazioni per cui un “agente artificiale” possiederebbe “agentività”. Come se bastasse chiamare qualcosa con un certo nome per conferirle anche le qualità sottintese. È un trucco linguistico insidioso: evocare un concetto per osmosi semantica, confidando che nessuno abbia il tempo (o la voglia) di chiedersi se ci sia sostanza dietro al suono delle parole.

E così si giunge a ciò che si potrebbe definire un equivoco sistemico. Ma a ben vedere, forse non si tratta di un effetto collaterale di un sistema complesso: è il risultato di una costruzione intenzionale, operata da chi ha tutto l’interesse a mantenere la confusione tra agente e agentività. Da chi magari crede davvero a quel che dice, oppure da chi (e sono i casi più gravi) sa perfettamente di mentire. E mente perché gli conviene.

Perché su quell’equivoco si possono costruire interi modelli di business, strategie comunicative, piani industriali. E quando la menzogna diventa utile, allora smette di essere un errore: diventa una scelta.

“Agenti AI”: l’ambiguità semantica servita su un piatto d’argento

Torniamo per un attimo alle basi. In informatica un agente è, semplificando brutalmente, un sistema che percepisce l’ambiente, lo elabora e agisce. Punto. Come un termostato, ma con una specializzazione in Machine Learning. Nessuna volontà, nessun desiderio, nessuna coscienza. Solo automatismi sofisticati, che reagiscono a input e producono output.

Eppure, eccoci qui, a sentire esperti che parlano di “agentività autonoma degli agenti artificiali”, come se avessimo a che fare con piccole creature esistenziali, impegnate in un’epica personale tra input e output, tra sogni binari e aspirazioni algoritmiche. Un po’ come se credessimo che un frigorifero scelga di non raffreddare per protestare contro il capitalismo energetico. L’ambiguità, come spesso accade in tecnologia, è il vero agente della confusione: perché se uso un termine che “suona” bene, posso far passare per plausibile qualsiasi sciocchezza.

È il potere delle etichette: basta una parola elegante su un concetto fragile per trasformarlo, quasi per magia, in verità condivisa. E quindi ecco che un’implementazione tecnico-operativa viene confusa in una vera e propria soggettività emergente. E qui è importante essere chiari: gli agenti artificiali sono un passo importantissimo nello sviluppo dell’AI. Proprio per questo, però, è fondamentale inquadrarli bene. Capirne le funzioni, i limiti, le implicazioni. Perché più li carichiamo di significati impropri, più perdiamo di vista il loro vero potenziale — e i rischi reali che comportano.

Agentività, questa sconosciuta

Cos’è, allora, questa agentività? È la capacità di agire in modo intenzionale, consapevole, finalizzato. È ciò che consente non solo di scegliere tra dire la verità o mentire, tra reagire d’impulso o riflettere, ma anche di farlo sulla base di una volontà, uno scopo, una deliberazione interna. È proprio ciò che segna il confine tra agire e reagire: la capacità di dare senso alle proprie azioni, non solo di compierle.

Insomma: è la qualità dell’agire umano in quanto tale. Non si misura in bit, non si modella in un diagramma Ulm, non si compila in Python. Attribuire agentività a un sistema software è, nel migliore dei casi, un errore concettuale. Nel peggiore, un falso ideologico: perché se una macchina ha agentività, allora è responsabile. Se è responsabile, allora le nostre scelte, anzi, le scelte che gli facciamo fare, sono sue. E noi? Assolti. Deresponsabilizzati. Liberi di puntare il dito contro l’algoritmo, come facevano i bambini con il fratellino immaginario, o peggio vittime dell’algoritmo cattivo che si ribella. Come in un remake distopico di Frankenstein, ma in chiave Silicon Valley, si costruisce così il mito dell’intelligenza artificiale che un giorno, stufa di eseguire comandi, deciderà di alzarsi dalla scrivania digitale per rovesciare il suo creatore.

È un’immagine affascinante, certo, ma completamente fuorviante: perché nessuna macchina desidera, nessun codice cova vendetta, e nessun algoritmo sogna pecore elettriche. Semplicemente, fa ciò per cui è stato progettato. E se fa qualcosa che non ci aspettiamo, la colpa è la nostra.

Ignoranza o mala fede? Questo è il dilemma

Se uno studente al primo anno inciampa su “agente” e “agentività”, si può sempre correggere con tono paziente. Ma se a farlo è un c-Level a scelta di una grande azienda tecnologica, o il consulente strapagato che scrive i white paper per Bruxelles, allora due sono le possibilità: o non sa cosa dice (ma come fa a ricoprire il suo ruolo?), oppure lo sa benissimo. E lo dice lo stesso. Perché far credere che un agente abbia agentività non è solo una svista semantica. È un atto politico. E come ogni atto politico che si rispetti, ha le sue derive.

La prima è quella della deresponsabilizzazione: si costruisce un racconto nel quale la tecnologia si auto-giustifica, si auto norma, si auto-legittima. Una narrazione comoda per chi la progetta, per chi la vende, per chi ne trae potere e profitto. È il trucchetto del mago: distrarre con una mano, mentre l’altra ruba il portafoglio. Solo che qui il portafoglio è la nostra capacità di decidere, di comprendere, di scegliere.

La seconda deriva è ancora più subdola: è quella del mito dell’intelligenza artificiale cattiva, imprevedibile, potenzialmente pericolosa. Una narrazione apocalittica che giustifica la necessità di un controllo, di una governance forte, di un’autorità regolatrice. E chi avvisa del pericolo? Sempre gli stessi che intendono governarla. Un cortocircuito perfetto: si crea l’allarme per proporsi come soluzione. Con buona pace della trasparenza, della pluralità e della competenza.

Il potere delle parole

La confusione tra agente e agentività è il classico esempio di come una parola possa ingannare più di mille immagini. Perché basta scegliere il termine giusto – o meglio, quello sbagliato ma suggestivo – per alterare la percezione della realtà. Se chiamassi “consulente strategico” un foglio Excel, qualcuno coglierebbe l’ironia; ma se dico “agente intelligente”, allora sembra che abbia installato James Bond su un server, pronto a sventare complotti informatici tra una query e l’altra. La metafora, da vezzo linguistico, diventa travestimento semantico: un modo per attribuire soggettività a ciò che soggetto non è.

Questi sistemi non pensano, non decidono, non scelgono. Reagiscono, operano, ottimizzano. Ma non agiscono in senso umano. Non hanno interessi, valori, scopi. Sono macchine. E, finché resta così (e resta così) è bene ricordarlo con ostinazione. Anzi, ripeterlo come un mantra. Perché sembreranno sempre più umani, useranno parole sempre più efficaci, avranno voci sempre più persuasive. Ma l’agentività resta – e continuerà a restare per un po’ – un tratto esclusivamente umano. Non siamo ancora nella fase in cui questi sistemi possano svilupparla.

E, a voler essere realistici, è più corretto dire che siamo ancora nel campo della fantascienza che in quello della previsione. Dunque: nessuna illusione, nessuna scorciatoia. La differenza fondamentale è tutta lì, e lì dobbiamo continuare a guardare.

La posta in gioco? La responsabilità

Il vero rischio non è solo semantico o terminologico. È politico, culturale, etico. Perché se continuiamo a parlare di agenti artificiali come se fossero agenti morali, finiamo per smarrire la distinzione fondamentale tra strumenti e soggetti. E quando gli strumenti diventano soggetti, i soggetti veri — cioè noi — spariscono dietro al paravento della tecnica.

Non è un caso che chi promuove queste confusioni spesso sia anche il primo a proporre “codici etici per l’AI”. Così, dopo lo Stato Etico, ci ritroviamo con l’Algoritmo Morale. Con buona pace di Kant e della sua idea di autonomia. Ma se vogliamo davvero un uso responsabile dell’intelligenza artificiale, dobbiamo prima smontare le narrazioni irresponsabili. E tra queste, quella che confonde l’agente con l’agentività è forse la più pericolosa, perché finge di parlare di tecnica mentre parla di potere.

La soluzione? Tornare alla grammatica. Al significato delle parole. Alla filosofia, quella vera, non quella da brochure. Perché solo se sappiamo distinguere un oggetto da un soggetto, un’automazione da un’intenzione, un algoritmo da un’azione potremo davvero decidere cosa farne, e con quali limiti.


CASO MARTINA STRAZZER, PARTE II: LUCARELLI VS. MATTEINI?

CASO MARTINA STRAZZER, PARTE II: LUCARELLI VS. MATTEINI?

Sui dettagli del caso Strazzer e Amabile non spendo una parola in più, è già stato detto di tutto, l’efficientissima AI del dott. Google potrà venire in soccorso dei pochi che in questo tranquillissimo agosto non hanno gettato un occhio ai Social, dove la polemica è impazzata; mentre per i palati più fini e gli addetti ai lavori rimando a quanto scritto dall’ottima Giorgia Grandoni, forse la più lucida e completa analisi di questa vicenda pubblicata online.

Ieri sera – finalmente, dopo un silenzio davvero troppo lungo – Martina Strazzer rompe gli indugi, con un’intervista all’opinionista (e non giornalista, ha lasciato l’Ordine nel 2023, dopo essere stata coinvolta in un procedimento disciplinare) Selvaggia Lucarelli.

Lucarelli era l’interlocutrice corretta?

L’intervista appare irrituale fin da subito per la scelta dell’interlocutrice: non già Charlotte Matteini, che per prima, con grande rigore, sollevò il caso il 12 agosto scorso, chiedendo peraltro anticipatamente a Martina Strazzer di dire la sua (richiesta mai esaudita, né al momento dei contatti tra loro, né nelle 3 settimane successive), bensì a un’altra donna – la Lucarelli – in grado sicuramente di garantire il giusto hype e una audience numericamente di tutto rispetto, ma che nulla c’entrava con la vicenda.

Certo, quale migliore megafono della più nota “distruttrice di influencer” d’Italia (vedasi caso Ferragni), la cui benevolenza e “assoluzione” potrebbe ridurre l’intensità della crisi e cambiarne gli esiti?

A margine, è bene ricordare che gli specialisti del settore si stanno interrogando sullo schema: i bene informati riferiscono che inizialmente Strazzer contattò alcuni validi colleghi tra Milano e Roma, ma la collaborazione non si perfezionò a causa dell’indisponibilità della giovane influencer ad accettare consigli, mettersi in discussione e presentare al pubblico scuse sincere e incondizionate. Cosa è cambiato ora, e chi ha convinto Strazzer a rilasciare un’intervista, aprendo il contatto con Lucarelli? (credere a un’operazione spontanea e auto-gestita, perdonatemi, offende l’intelligenza di chi la crisis-communication la pratica per mestiere).

Al netto di queste domande (attualmente) senza risposta, l’intervista Strazzer/Lucarelli non convince del tutto. Complice l’insonnia, alle tre di questa notte scrivevo al mio team:

“Ho letto l’intervista, vi dico due cose: il testo molto probabilmente non è frutto di una sbobinatura autentica come vuol far credere la Lucarelli, ma paiono più essere domande e risposte perfezionate per iscritto, o comunque “aggiustate” in modo agiografico (non so quale sia stato l’interesse della Lucarelli, a parte dimostrare di essere sul pezzo, ma l’intervista non appare del tutto “spontanea”); in secondo luogo, il dossier Amabile non si chiude qui, con questa intervista. Il tempo ci dirà se ho ragione”

Poche ore dopo, stamattina, Matteini è uscita con un suo nuovo video, preannunciando novità (anche su questo spenderemo due parole in chiusura di questo articolo).

Manteniamo tuttavia il focus sull’intervista Strazzer/Lucarelli, concentrandoci su alcuni importanti indicatori semantici, noti non certo da oggi: sono infatti molti gli autori che in passato hanno studiato questo genere di fenomeni, da Patrick Charaudeau, che ha approfondito il “contratto comunicativo” riscontrabile in certe interviste e le modalità di costruzione dell’immagine pubblica tramite esse, a Umberto Eco, che in ambito semiotico ha dimostrato come alcuni testi vengano costruiti per orientare l’interpretazione del lettore/spettatore, fino alle ricerche proprie del filone dell’analisi conversazionale, il cui padre scientifico è il sociologo e linguista statunitense Harvey Sacks, che analizzano appunto le caratteristiche dell’interazione verbale e in particolare come le persone si rapportano tra loro in contesti “faccia a faccia”, approfondendo i modelli e le strutture dei dialoghi (interviste incluse, quindi) per comprendere meglio l’interazione umana e come gli individui possano cooperare negli scambi di opinioni, pensieri e sentimenti (in appendice, chi fosse interessato potrà trovare una breve bibliografia a riguardo).

Non pochi indizi paiono allarmanti. Capiamo perché.

Le apparenti non conformità dell’intervista Strazzer/Lucarelli

In primo luogo, nell’intervista si registra una carenza di spontaneità linguistica, che emerge – paradossalmente – dall’abuso di alcuni marcatori di incertezza, che se è vero sono comuni nel parlato spontaneo, nel testo pubblicato da Lucarelli paiono utilizzati con precisione chirugica al fine di far apparire spontaneo un testo che in realtà non lo è.

Le risposte sono prive di esitazioni o digressioni, e soprattutto il tone-of-voice è quello di chi “imbocca” la risposta sulla base di uno schema narrativo predefinito (per esempio: “Le tue collaboratrici sono tutte impaurite, immagino”, o “Sara si proclamava anche tua fan, immagino”, o ancora “Questa cosa ti terrorizza, immagino”…): in poche parole, le domande – a volte formulate persino con tono retorico – traghettano esattamente a una precisa risposta, e gli esempi in tal senso nel testo sono numerosi.

In non pochi casi, è rilevabile un allineamento perfetto tra domanda e risposta, con le risposte che sono la consecuzione esatta, dal punto di vista del contenuto, dell’incipit della domanda, in modo convinto e senza alcuna umana esitazione. Il testo in poche parole pare essere – se letto maliziosamente – la perfetta risposta al quesito: “se dovessimo emettere un comunicato stampa, conterrebbe questi elementi. Come possiamo destrutturarlo per farlo apparire come fosse un dialogo genuino?”.

Lucarelli poi (stranissimo, e poco aderente allo stile tipico alla quale ci aveva abituati l’opinionista) pone a Strazzer tutte – nessuna esclusa – le domande alle quali l’influencer avrebbe probabilmente voluto rispondere in occasione di una conferenza stampa (“È la vostra prassi quella di fare contratti a tempo determinato per passare poi a contratti a tempo indeterminato?”, oppure “Perché a Sara non è stato rinnovato il contratto?” etc). Nulla di inopportuno, ma rafforza l’idea che domande e risposte possano essere figlie di una precisa e attenta regia.

Inoltre, le domande critiche o tali da generare un contraddittorio sono poste (quando sono poste, perché molti dei quesiti sollevati da Matteini non sono stati affrontati) in modo amabile (sic!) e comunque mai realmente incisivo, e in molti casi “indicano” già l’exit-way della risposta “comoda” (il che rappresenta un unicum per Lucarelli), ad esempio come quando si tenta di “sterilizzare” la passata vicenda dei gioielli comprati in Cina e spacciati per produzioni di Amabile: mancano domande poste in maniera genuinamente scomoda, il che è un possibile indicatore di controllo sull’intervista da parte dell’intervistato (o del suo staff).

L’intervistata sembra seguire una narrazione ben costruita, con messaggi di scuse o auto-assolutori ripetuti più e più volte, quasi a voler far breccia nell’immaginario del pubblico “cristallizzando” una precisa narrazione giustificativa finalizzata a permettere a Strazzer di “archiviare il caso”, e la Lucarelli pare collaborare attivamente a questo disegno, con affermazioni smaccatamente agiografiche del tipo “Sembri molto solida, non pensavo che a 25 anni avessi questa tenuta psicologica…”.

È rilevabile una coerenza eccessiva tra varie risposte, che traghettano il lettore a destinazione fissando dei concetti chiave: “se la ragazza è stata licenziata c’erano dei precisi e gravi motivi, non ho risposto subito alle critiche perché volevo fare approfondimenti seri, e qualunque errore io abbia commesso è stato fatto in buona fede, per cui mi scuso, e ora passiamo oltre”, questo è – in sintesi – ciò che sostanzialmente dice Strazzer.

L’intervista, in definitiva, si sostanzia in un momento di autopromozione e di costruzione di uno storytelling fin eccessivamente benevolo e sempre auto-giustificativo: Strazzer nel 100% delle sue affermazioni “si scusa ma…” (…ma ero giovane, ma non sono stata capita, ma ero oberata dal lavoro, ma non avevo personale adeguato, etc…).

Tutto è quindi molto coerente e bilanciato, e pare così ben organizzato, dal punto di vista narrativo, da generare il sospetto – attendo smentite – di una preparazione o revisione ex post del testo.

La vicenda si chiude qui, con il “viaggio dell’eroe” di Strazzer?

Sulle non conformità della strategia di Strazzer e Amabile dal punto di vista della crisis-communication è già stato detto e scritto molto (incluse le scuse inefficaci presentate qualche giorno fa via Social, con delle storie testuali molto algide), ma ciò che è certo è che questa intervista rilasciata a Lucarelli si sostanzia in un perfetto “viaggio dell’eroe” (la struttura narrativa resa popolare dallo sceneggiatore Christopher Vogler, basata sul lavoro di Joseph Campbell) che delinea varie tappe ritenute di appeal per rappresentare la crescita e la trasformazione della protagonista: è uno schema applicabile a storie di ogni genere, che include l’uscita dal mondo ordinario, il superamento di prove e la vittoria su nemici o ostacoli, l’ammissione di colpe e inadeguatezze (cit. Lucarelli: “Un pianto te lo sarai fatto, sei umana…”), fino al ritorno al mondo d’origine con un dono o una “maggiore consapevolezza”, che è poi la morale che Strazzer vuole far trasparire dalla sua intervista, con la complicità (ops, volevo scrivere collaborazione) di Lucarelli.

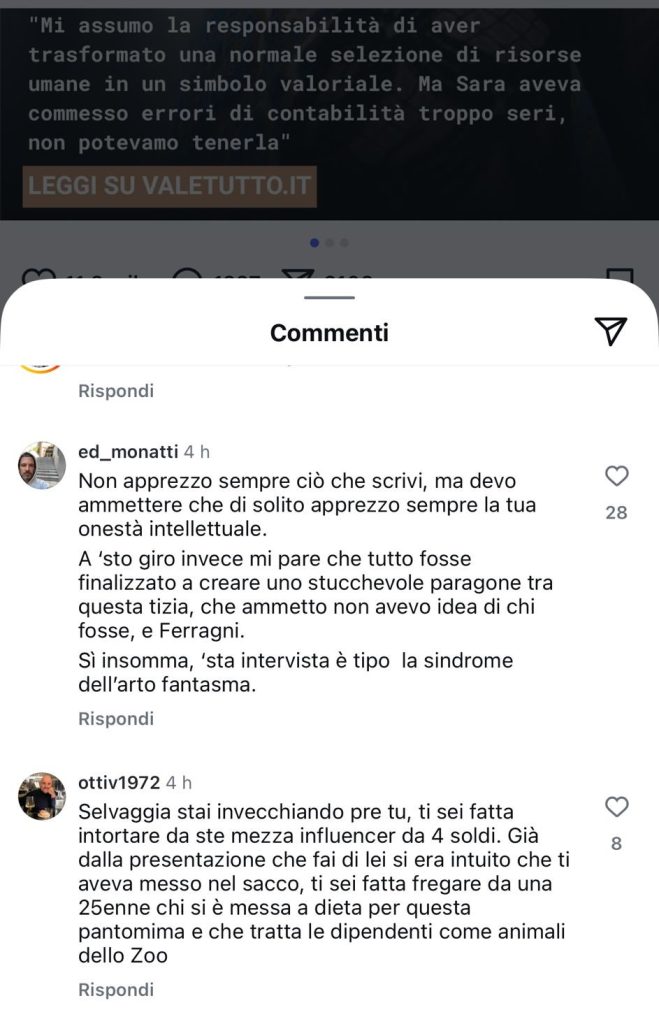
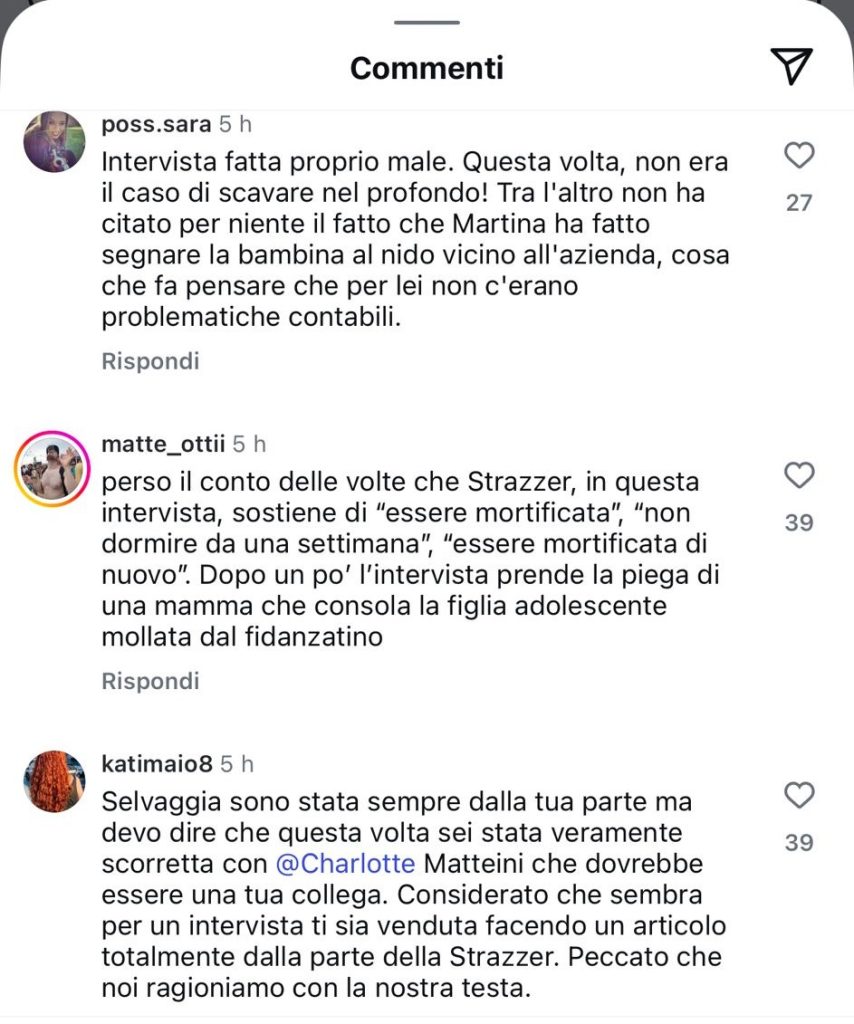
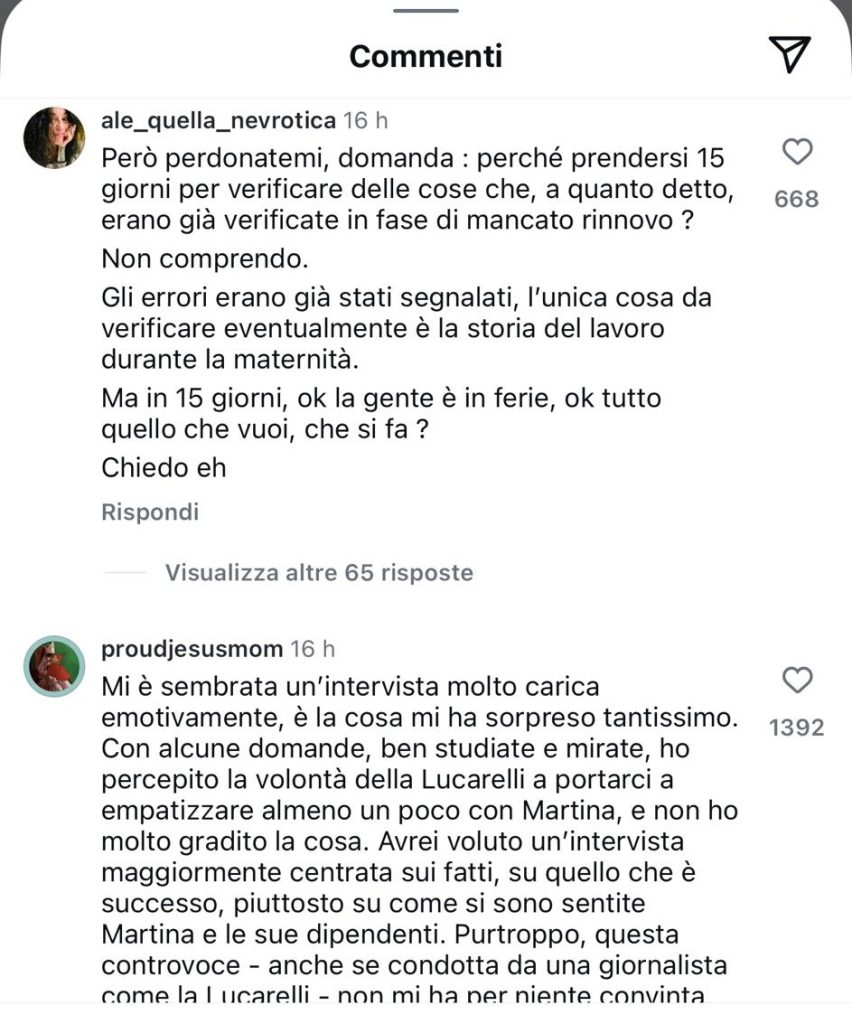
L’intervista – qualora il caso avesse un seguito, con nuove rivelazioni della Matteini – potrebbe quindi rivelarsi un boomerang reputazionale non solo per Martina Strazzer, ma anche per la stessa Lucarelli, la quale peraltro pare non stia esitando (altra cattiva prassi nella gestione dei dibattiti on-line) a cancellare non pochi commenti critici da parte di membri della sua community (ne riportiamo alcuni qui per rendere l’idea di un sentiment non sempre positivo da parte della sua stessa audience):

La Matteini per contro nel suo video di stamattina ha preannunciato risposte, prendendo la parola – in modo tanto assertivo quanto informale – in bikini dalla spiaggia, durante un momento di relax: la speranza vivissima è che questa delicata e rilevante vicenda non si riduca a dissing tra due note opinioniste, e che possa aver la meglio, su tutto, il buon giornalismo.

Di sicuro, to be continued…


Breve bibliografia:

  • Charaudeau, P. – Le discours d’information médiatique. La construction du miroir social, Vuibert Parigi, 2005
  • Clayman, S. E., & Heritage – J., The News Interview: Journalists and Public Figures on the Air, Cambridge University Press, Cambridge, 2002
  • Eco, U. – Lector in fabula. La cooperazione interpretativa nei testi narrativi, Bompiani, Milano, 1979
  • Fairclough, N. – Media Discourse, Edward Arnold, Londra, 1995
  • M., Taylor, S., & Yates, S. J. (Eds.) – Discourse Theory and Practice: A Reader (pp. 311–324).
    Sage, Londra, 2001
  • Van Dijk, T. A. – Discourse and Power, Palgrave Macmillan, Basingstoke, 2008
  • Wodak, R. – The Politics of Fear: What Right-Wing Populist Discourses Mean, Sage, Londra, 2015
  • Wodak, R. – The Discourse of Historical Approaches, In Wetherell, 2001


SENTENZA STORICA IN CALIFORNIA: PRIMI PALETTI LEGALI PER L’ADDESTRAMENTO DELLE IA SUI CONTENUTI PROTETTI 

LA DIRETTIVA EUROPEA CHE RIVOLUZIONA LE FILIERE PRODUTTIVE DEL TESSILE
avv. Rosalba Tubère

Per la prima volta un Tribunale Federale statunitense ha tracciato con rigore giuridico i confini legali entro cui è lecito utilizzare opere protette da copyright per addestrare sistemi di intelligenza artificiale.

È una decisione epocale che farà storia perchè segna lo spartiacque nel diritto di autore dell’intelligenza artificiale generativa.

Ma vediamo come il Giudice William Alsup definisce i parametri normativi nel contesto del copyright digitale.

Tutto nasce da tre Autori  – Kirk Wallace Johnon , Charles Graeber ed Andrea Bartz- che hanno scoperto l’utilizzo non autorizzato delle loro opere letterarie per l’addestramento di Claude, l’assistente IA  sviluppato da Anthropic PBC (società partecipata da Amazon e Alphabet).

Ma attenzione alla strategia operativa di Anthropic: da un lato aveva utilizzato oltre sette milioni di opere da fonti pirata; dall’altro aveva acquistato legittimamente milioni di copie fisiche sottoponendole a digitalizzazione mediante scansione “distruttiva“ ( cioè senza ulteriore possibilità di operare copie fisiche del libro).

Questa duplice modalità ha consentito al Giudice Alsup di operare la distinzione fondamentale tra due distinte fattispecie giuridich; le ha analizzate separatamente dando un’interpretazione innovativa della dottrina sull’uso corretto dell’intero ecosistema tecnologico.

Il Giudice ha stabilito che l’addestramento di modelli linguistici di grandi dimensioni (LLM) costituisce un uso “estremamente trasformativo” delle opere originali, quindi legittimo!

Ha evidenziato che i modelli linguistici non hanno riprodotto al pubblico gli estremi creativi di un’opera data, né lo stile espressivo identificabile di un autore. Per il diritto di autore statunitense la trasformatività rappresenta uno dei fattori cardine nella valutazione di un uso legittimo.

Il Giudice è pervenuto a questa conclusione con una metafora molto evocativa : come qualsiasi lettore che aspiri a diventare scrittore, i modelli linguistici di Anthropic si sono addestrati sulle opere non per replicarle o soppiantarle, ma per cambiarle e creare qualcosa di diverso.

Questa analogia con il processo creativo umano stabilisce un precedente di cardinale importanza, è il paradigma di riferimento di tutto l’ecosistema tecnologico!

Ha inoltre definito ed operato una tripartizione tra le diverse modalità di acquisizione dei contenuti. Prima categoria: l’utilizzo di opere legittimamente acquistate per l’addestramento di IA. La seconda categoria: la conversione formato di opere legittimamente acquistate e la sua sostituzione digitale con distruzione della copia originale analogica. La terza categoria: utilizzo di biblioteche pirata.

Per la prima categoria l’utilizzo è consentito e non viola alcun copyright perchè è un uso trasformativo, paragonabile all’apprendimento umano.

Anche la seconda categoria è lecita perché si basa su opere legittimamente acquistate e solamente convertite in altro formato.

La terza categoria è vietata in maniera non sanabile. La copia e l’archiviazione di libri provenienti da fonti pirata costituisce una violazione dei diritti d’autore, trattasi di una provenienza illegittima. Inoltre trattandosi di una violazione dolosa del copyright comporta una richiesta risarcitoria .

Nel caso che ci occupa sarà il Tribunale, nell’udienza che si terrà a dicembre di quest’anno, a quantificare l’entità precisa del danno dovuto per l’uso delle copie pirata. Questa sentenza costituirà il precedente cruciale per il risarcimento in casi analoghi nell’ambito di IA training.

Quello che ci interessa è evidenziare, oltre il caso specifico, i criteri che le aziende di IA dovranno necessariamente implementare per agire correttamente.

Occorre una specifica due diligence sulla provenienza dei dataset per verificare la legalità delle fonti.

La documentazione della catena di acquisizione deve garantire la tracciabilità completa.

Sarà requisito fondamentale differenziare i contenuti di origine legittima da quelli potenzialmente problematici, effettuando audit periodici sulla conformità dei processi di training.

E l’Europa?

Il nostro AI Act impone obblighi normativi facilmente esercitabili dagli aventi diritto.

L’opzione di esclusione esercitata dall’autore attraverso la pubblicazione delle condizioni generali d’uso del proprio sito web impedisce in maniera chiara l’utilizzo dei propri contenuti protetti dal diritto d’autore ad opera di società che addestrano IA .

Sarà quindi indispensabile per chi vuole tutelare i propri diritti adottare una gestione contrattuale chiara e vincolante circa le condizioni applicabili agli utenti e ai soggetti che acquisiscono i contenuti protetti dei dataset. L’Unione Europea attribuisce pieno valore alla volontà dell’autore, anche se espressa al di fuori di un atto di diniego diretto.


Questa volta è Forbes che paga per le sue classifiche

Questa volta è Forbes che paga per le sue classifiche

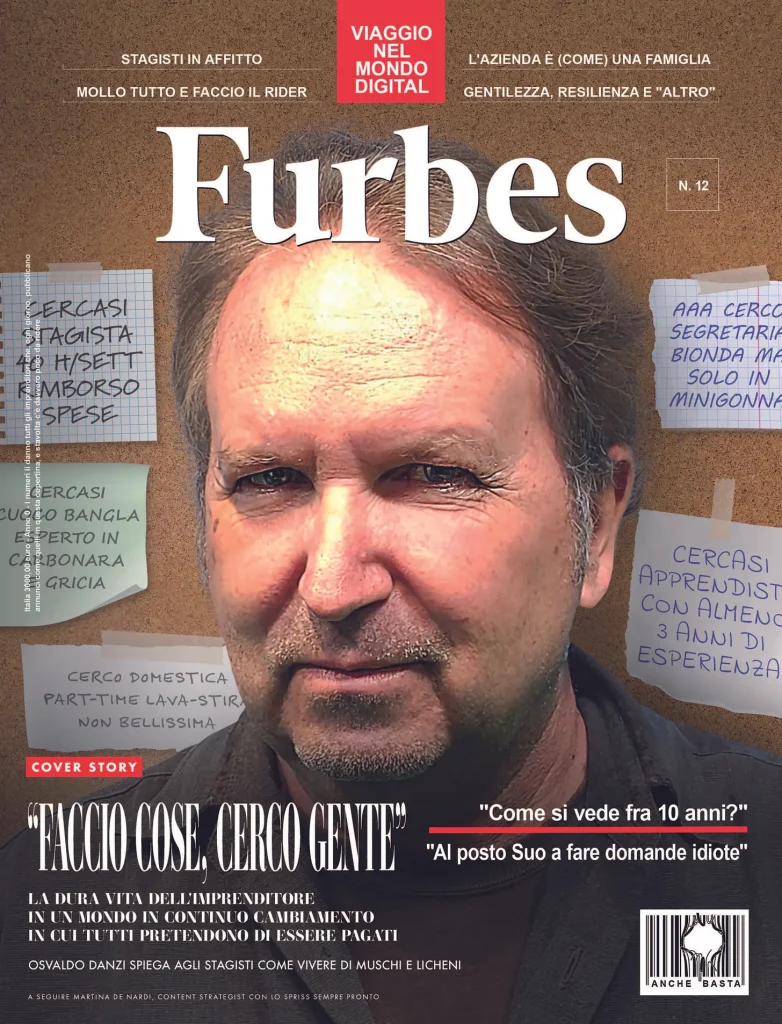
Il 20 marzo del 2023 ho condiviso sul mio profilo Linkedin un post intitolato “se non hai 1500 euro per comparire nelle liste di Forbes, rivolgiti a Furbes”, corredato con l’immagine della copertina di FURBES (con la “u”) con il mio faccione in bella vista.

Furbes (con la “u”) è la geniale idea di Danilo Spanu, esperto di comunicazione, che ha coinvolto una serie di amici, liberi professionisti in vari settori, totalmente invisibili (per ovvi motivi) dalla stampa manageriale, per realizzare una parodia delle copertine di FORBES (con la “o”).

Si tratta di un’innocua presa in giro di termini e situazioni tipiche di un certo tipo di management imbruttito e autoreferenziale alimentato proprio da quel tipo di giornali. Che questa operazione sia puro divertimento, lo capirebbe anche un bambino leggendo i titoli dei finti articoli: “Cambi spesso posizione lavorativa? Si, ogni tanto mi sdraio” “assumere più candidati e meno carboidrati” e “Dubai: i posti migliori per le dirette”

Ma evidentemente gli avvocati della “boutique legale” (così si definiscono) di Forbes (con la “o”) devono avere il senso dell’humour di un elettricista polacco al punto tale da dare corda al loro autorevole cliente, intimandomi di cancellare il post in cui si ravvedeva un’evidente intento diffamatorio.

Fermo restando che se come dicono loro, la Costituzione tutela le persone dalla diffamazione, la legge le tutela anche dalle truffe più o meno celate e la deontologia professionale imporrebbe ai giornali e ai loro editori e direttori di essere trasparenti quando pubblicano certi contenuti, chiamandoli col loro nome: pubblicità. Esiste infatti un termine preciso per gli articoli che promuovono servizi, prodotti o persone: quel termine è “publiredazionale” e deve essere chiaramente segnalato su ogni testata.

Ciò che evidentemente dà davvero fastidio a Forbes (con la “O”) è che si venga a sapere quale sia il modello di business con cui questo genere di testate si sostengono. Parlo al plurale perché Forbes è solo la più nota, ma non l’unica.

Alla fine si è espressa l’AGCM, sanzionando Forbes per “pubblicità occulta”, in quanto l’inserto in cui si mettevano in fila “i ristoranti più innovativi” era di fatto, in tutto e per tutto, un publiredazionale mascherato da guida, in cui i ristoratori hanno pagato, senza se e senza ma, per comparirvi.

L’inchiesta sui ristoranti innovativi, partita dalla Lucarelli

Il tutto nasce in seguito ad un’inchiesta della Lucarelli che ha sollevato il coperchio del pentolone.

Coperchio e pentolone in tutti i sensi, visto che l’oggetto della sua inchiesta riguardava un improbabile inserto di Forbes Italia, in collaborazione con Il Forchettiere, in cui si elencano i 100 ristoranti più innovativi.

Alcuni ristoratori sono usciti allo scoperto e hanno dichiarato di essersi rifiutati di pagare 2500 euro per comparire nell’inserto curato da Marco Gemelli, ideatore della guida, al punto tale da costringere il direttore di Forbes Alessandro Mauro Rossi ad ammettere che (effettivamente) QUALCHE ristorante ha pagato per la sua presenza. Ma – secondo il direttore di Forbes – non c’è dolo perché comunque sono tutti ristoranti di qualità. Ah, beh….

Sul fatto poi che l’ideatore dell’inserto curi anche l’ufficio stampa di alcuni di quei ristoranti, che il direttore del giornale abbia pubblicato un editoriale chilometrico senza segnalare che tutti i nominati avessero pagato e che quindi si trattasse di un publiredazionale fatto e finito e che siccome l’inserto è in regalo – parole sue – ad un lettore non cambia nulla sapere se un brand o un professionista ha pagato per essere inserito in una lista, la dice lunga sulla deontologia professionale e la credibilità di Forbes.

Mi piacerebbe sapere cosa ne pensa la boutique legale & professionale che manda le lettere minatorie a chi si permette di affermare la pura verità e difende invece chi ritiene irrilevante ciò che differenzia un articolo da una pubblicità.

Il “metodo Forbes”

Ma guardiamo oltre, come fanno notare molti lettori che hanno commentato il mio post su Linkedin, il modus operandi di queste testate è più noto di quanto non si pensi, e le classifiche a pagamento non si circoscrivono all’inserto sui ristoranti ma si estendono anche e di più alle aziende più innovative, alle donne più influenti, gli startupper che cambieranno il mondo, i manager più più più… E il format é sempre lo stesso.

Si inserisce nella lista uno specchietto per le allodole che in genere è uno sportivo importante, un brand rilevante, un caso di successo stranoto, l’Amministratore Delegato di un’azienda di largo consumo utili a referenziare il resto della lista composta da semi-perfetti sconosciuti senza arte né parte che invece pagano una cifretta molto accessibile per comparire nella lista. Io sapevo 1500 euro – come ricorda la lettera minatoria degli avvocati di Forbes – ma si vede che l’inflazione galoppa e c’è stata una ritoccatina al prezzario.

Viene da domandarsi: se tutti sanno che quelle liste sono palesemente farlocche, per quale motivo ci sono avvocati, manager d’azienda, CEO e startappari che spendono soldi per comparirci?

Ma che reputazione è, una reputazione che si compra?

A quanto pare c’è qualcuno che crede che comparire su quelle pagine e in quelle classifiche convinca i lettori, gli amici (che evidentemente non hanno), le fidanzate e le mogli, i compagni e i mariti, i colleghi e i clienti di essere “i migliori”.

Una domanda in più però va fatta e riguarda tutti coloro che sui social applaudono e si congratulano con chi adotta un sistema simile per ottenere visibilità.

Perché se è vero che da una parte ci sono centinaia di commenti sui social in cui quelle classifiche vengono puntualmente derise (per usare un termine elegante), non è difficile ritrovare gli stessi, meschini, che la settimana prima perculavano il giovane startupper dell’anno, che oggi si spellano le mani sui post dei loro capi, conoscenti, clienti o il più delle volte solo aspiranti clienti, nella speranza chissà, un giorno, di ottenere un favore, un mandato, un lavoretto, un minimo di patetica attenzione.

Ecco.
Miserabili i primi, ma anche i secondi.